Use Reference Image 1 only for the proud pigeon with the aviator scarf. Use Reference Image 2 only for the oversized croissant. Use Reference Image 3 only for the subway grab handle. In one continuous five-second shot, the Image 1 pigeon holds the Image 2 croissant in its beak and stands on the Image 3 subway handle, swaying with the train. Camera: waist-height handheld sway matching the subway motion. No cuts. Synchronized audio: subway rumble, a proud coo, a faint pastry flake crunch. No readable text, letters, numbers, captions, labels, logos, brands, watermarks, advertisements, posters, UI screens, or product packaging.
Wan 3.0 Reference-to-Video API
alibaba/wan-3.0/reference-to-videoWan 3.0(Reference-to-Video)将文本提示词与图像、视频、音频、文档或网页等多模态参考资产转化为动态视频,支持多达 20 项组合素材输入与 2–30 秒单次连续生成。它能够跨镜头稳定继承主体身份、艺术风格与叙事逻辑,同时结合输入资产合成原生音画同步的连贯影像。
输入
631/20000
参考素材总数3/21 · 剩余 18
3/10 · 剩余 7
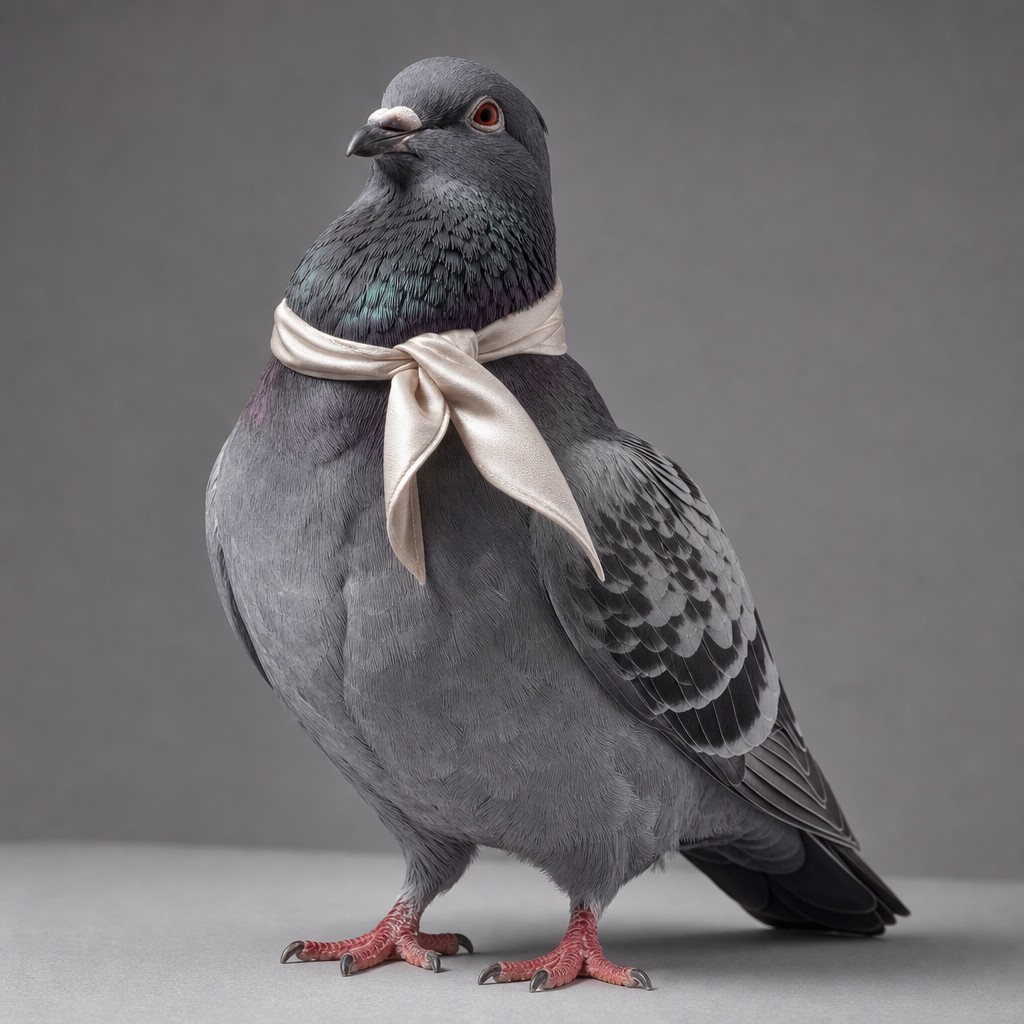
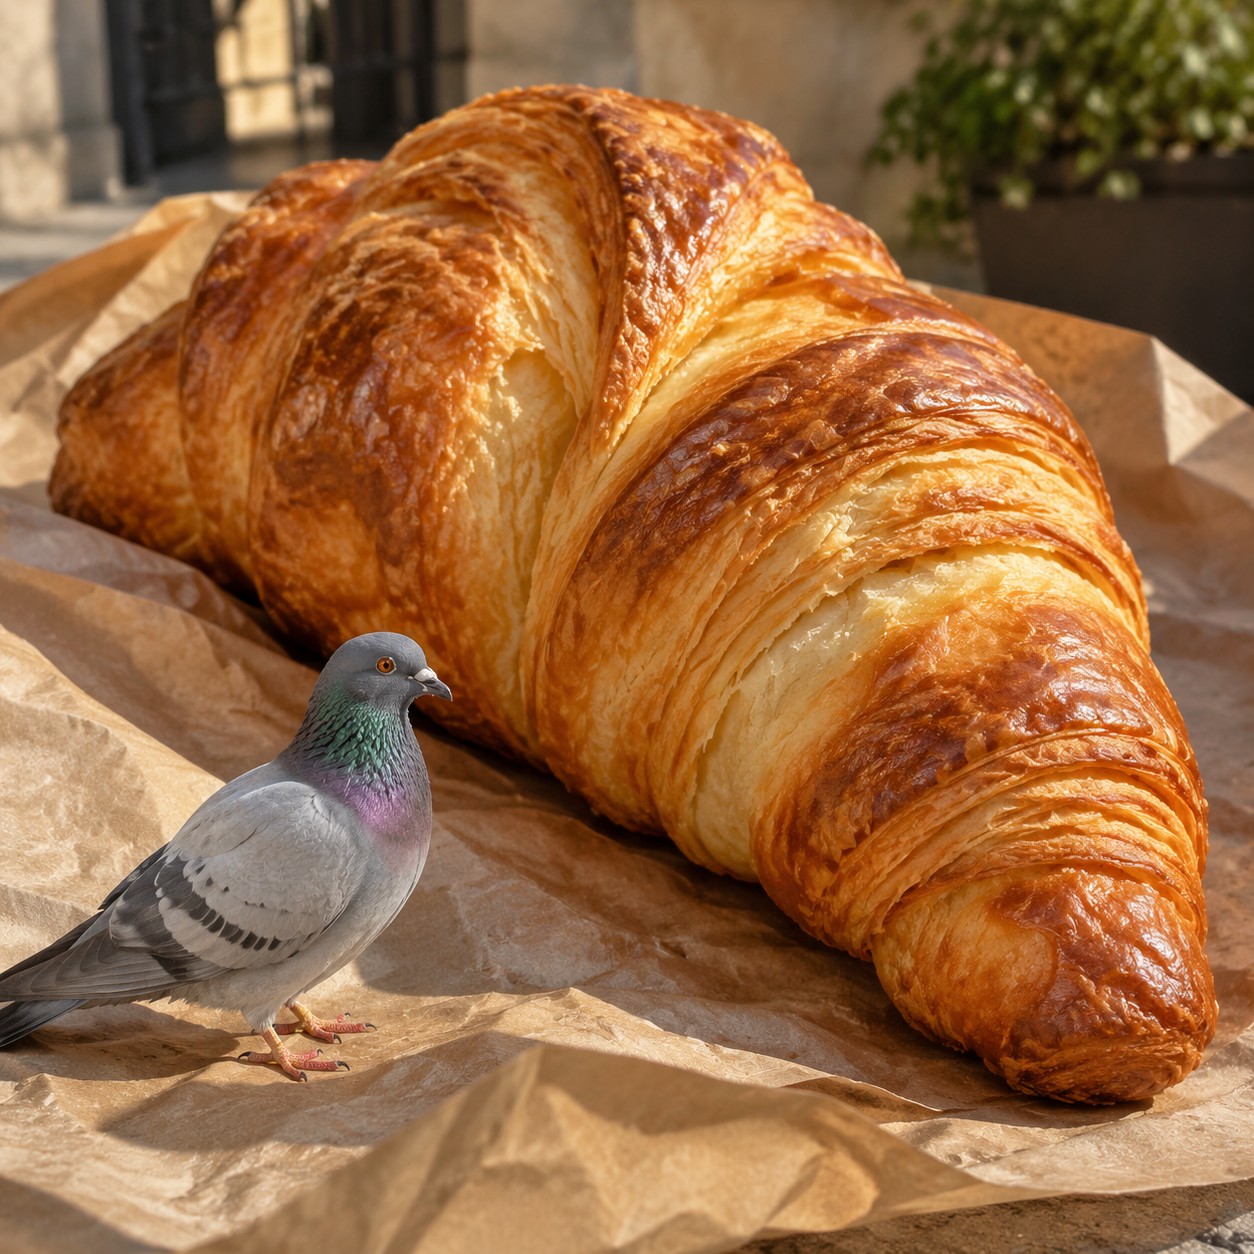
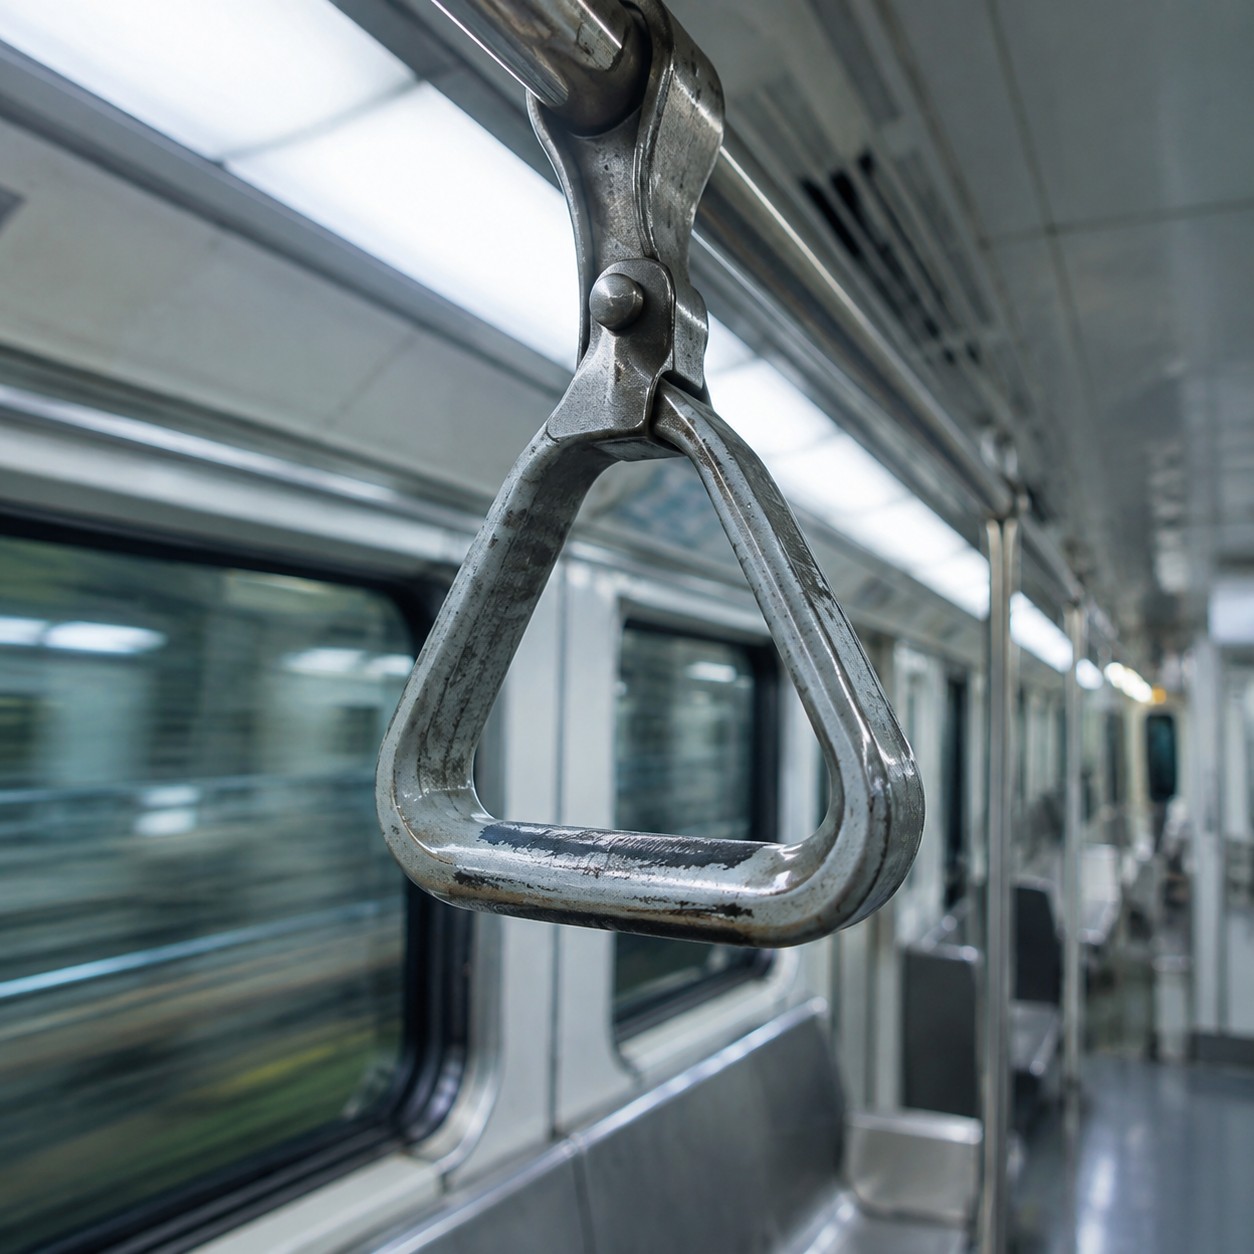
0/5 · 剩余 5
0/5 · 剩余 5
输出
已就绪继续使用
示例
REST API 规格
快速开始
组合多模态参考素材与文本提示词提交任务,并轮询状态接口获取高清一致性视频结果。
01
第一步:配置 API 鉴权
在控制台申请 API Key,并在每个 HTTP 请求头中携带 Authorization: Bearer <API_KEY> 进行身份验证。
- 任务提交端点
- POST
https://api.vidgo.ai/api/generate/submit - 鉴权请求头
- Authorization: Bearer VIDGO_API_KEY
02
第二步:提交参考生视频任务
向 /api/generate/submit 端点发起 POST 请求,指定 model 为 alibaba/wan-3.0/reference-to-video,在 input 中填入 prompt 与参考素材数组。 可仅使用音频作为参考,仍须提供提示词。
提交请求载荷
REQUEST_BODY=$(cat <<'JSON'
{
  "model": "alibaba/wan-3.0/reference-to-video",
  "input": {
    "prompt": "Use Reference Image 1 only for the proud pigeon with the aviator scarf. Use Reference Image 2 only for the oversized croissant. Use Reference Image 3 only for the subway grab handle. In one continuous five-second shot, the Image 1 pigeon holds the Image 2 croissant in its beak and stands on the Image 3 subway handle, swaying with the train. Camera: waist-height handheld sway matching the subway motion. No cuts. Synchronized audio: subway rumble, a proud coo, a faint pastry flake crunch. No readable text, letters, numbers, captions, labels, logos, brands, watermarks, advertisements, posters, UI screens, or product packaging.",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "adaptive",
    "audio": true,
    "enable_safety_checker": true,
    "reference_image_urls": [
      "https://cdn.vidgo.ai/apis/models/alibaba/wan-3.0/reference-to-video/v1/01/input-01.jpg",
      "https://cdn.vidgo.ai/apis/models/alibaba/wan-3.0/reference-to-video/v1/01/input-02.jpg",
      "https://cdn.vidgo.ai/apis/models/alibaba/wan-3.0/reference-to-video/v1/01/input-03.jpg"
    ]
  }
}
JSON
)

RESPONSE=$(curl --silent --show-error --fail-with-body \
  --request POST \
  --url "https://api.vidgo.ai/api/generate/submit" \
  --header "Authorization: Bearer $VIDGO_API_KEY" \
  --header "Content-Type: application/json" \
  --data "$REQUEST_BODY")

CODE=$(printf '%s' "$RESPONSE" | jq -r '.code // empty')
if [ "$CODE" != "0" ] && [ "$CODE" != "200" ]; then
  printf 'API error: %s
' "$RESPONSE" >&2
  exit 1
fi
printf '%s
' "$RESPONSE"
03
第三步:轮询任务执行结果
使用 task_id 查询进度;not_started 或 running 时继续轮询,finished 或 failed 时停止。成功后读取 data.files[].file_url,失败时读取 data.error_message。
状态查询端点
GET https://api.vidgo.ai/api/generate/status/{task_id}使用 task_id 查询进度;not_started 或 running 时继续轮询,finished 或 failed 时停止。成功后读取 data.files[].file_url,失败时读取 data.error_message。
not_startedrunningfinishedfailed提交响应结果
{
  "code": 200,
  "data": {
    "task_id": "task-wan30-r2v-774129",
    "status": "running",
    "created_time": "2026-09-16T08:40:00Z"
  }
}
完成响应数据
{
  "code": 200,
  "data": {
    "task_id": "task-unified-...",
    "status": "finished",
    "files": [
      {
        "file_url": "https://storage.vidgo.ai/generated/video.mp4",
        "file_type": "video"
      }
    ],
    "created_time": "2026-08-22T10:00:00Z",
    "progress": 100,
    "error_message": null
  }
}
端到端完整脚本示例
展开查看在生产环境中具备轮询重试、异常保护和超时处理的完整自动化脚本。
端到端完整脚本示例
set -euo pipefail
: "${VIDGO_API_KEY:?Set VIDGO_API_KEY in your environment}"

REQUEST_BODY=$(cat <<'JSON'
{
  "model": "alibaba/wan-3.0/reference-to-video",
  "input": {
    "prompt": "Use Reference Image 1 only for the proud pigeon with the aviator scarf. Use Reference Image 2 only for the oversized croissant. Use Reference Image 3 only for the subway grab handle. In one continuous five-second shot, the Image 1 pigeon holds the Image 2 croissant in its beak and stands on the Image 3 subway handle, swaying with the train. Camera: waist-height handheld sway matching the subway motion. No cuts. Synchronized audio: subway rumble, a proud coo, a faint pastry flake crunch. No readable text, letters, numbers, captions, labels, logos, brands, watermarks, advertisements, posters, UI screens, or product packaging.",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "adaptive",
    "audio": true,
    "enable_safety_checker": true,
    "reference_image_urls": [
      "https://cdn.vidgo.ai/apis/models/alibaba/wan-3.0/reference-to-video/v1/01/input-01.jpg",
      "https://cdn.vidgo.ai/apis/models/alibaba/wan-3.0/reference-to-video/v1/01/input-02.jpg",
      "https://cdn.vidgo.ai/apis/models/alibaba/wan-3.0/reference-to-video/v1/01/input-03.jpg"
    ]
  }
}
JSON
)

SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  --request POST \
  --url "https://api.vidgo.ai/api/generate/submit" \
  --header "Authorization: Bearer $VIDGO_API_KEY" \
  --header "Content-Type: application/json" \
  --data "$REQUEST_BODY")

TASK_ID=$(printf '%s' "$SUBMIT_RESPONSE" | jq -r '.data.task_id // .task_id // empty')
BUSINESS_CODE=$(printf '%s' "$SUBMIT_RESPONSE" | jq -r '.code // empty')
if [ "$BUSINESS_CODE" != "0" ] && [ "$BUSINESS_CODE" != "200" ]; then
  printf 'Submit failed:
%s
' "$SUBMIT_RESPONSE" >&2
  exit 1
fi
if [ -z "$TASK_ID" ]; then
  printf 'Submit response did not include task_id:
%s
' "$SUBMIT_RESPONSE" >&2
  exit 1
fi

START_TIME=$(date +%s)
POLL_DELAY=2
while true; do
  if [ $(( $(date +%s) - START_TIME )) -ge 600 ]; then
    printf 'Timed out after 600 seconds
' >&2
    exit 1
  fi
  STATUS_RESPONSE=$(curl --silent --show-error --fail-with-body \
    --url "https://api.vidgo.ai/api/generate/status/$TASK_ID" \
    --header "Authorization: Bearer $VIDGO_API_KEY")
  STATUS=$(printf '%s' "$STATUS_RESPONSE" | jq -r '.data.status // .status // empty')
  BUSINESS_CODE=$(printf '%s' "$STATUS_RESPONSE" | jq -r '.code // empty')
  if [ "$BUSINESS_CODE" != "0" ] && [ "$BUSINESS_CODE" != "200" ]; then
    printf 'Status request failed:
%s
' "$STATUS_RESPONSE" >&2
    exit 1
  fi

  case "$STATUS" in
    finished)
      printf '%s' "$STATUS_RESPONSE" | jq -r '(.data.files // .files // [])[]?.file_url'
      break
      ;;
    failed)
      printf '%s' "$STATUS_RESPONSE" | jq -r '.data.error_message // .error_message // "Generation failed"' >&2
      exit 1
      ;;
    not_started|running)
      sleep "$POLL_DELAY"
      if [ "$POLL_DELAY" -lt 10 ]; then POLL_DELAY=$((POLL_DELAY + 1)); fi
      ;;
    *)
      printf 'Unexpected task status: %s
' "$STATUS" >&2
      exit 1
      ;;
  esac
done
请求参数(input 对象)
向 /api/generate/submit 提交 POST 请求时,input 内部所支持的参考生视频参数:
| 字段 | 类型 | 必填 | 默认值 | 描述 |
|---|---|---|---|---|
| prompt | string | 是 | - | 描述生成场景、动作时序、镜头语言并指定参考资产角色的提示词,支持 1–20,000 字符。 |
| reference_image_urls | array[string] | 否 | [] | 参考图片 URL 数组(最多 10 张,单张 ≤30MB,支持 JPEG/PNG/WebP)。 |
| reference_video_urls | array[string] | 否 | [] | 最多 5 个公开 HTTP(S) 参考视频 URL,用于引导动作、运镜或节奏。 |
| reference_audio_urls | array[string] | 否 | [] | 参考音频 URL 数组(最多 5 个,单个 ≤50MB,支持 MP3/WAV)。 可作为唯一参考类型。 |
| reference_file_urls | array[string] | 否 | [] | 最多 1 个公开 HTTP(S) 文档 URL,与 reference_link_urls 互斥。 |
| reference_link_urls | array[string] | 否 | [] | 最多 1 个公开免登录网页 URL;与 reference_file_urls 互斥。 |
| duration | integer | 否 | 5 | 生成视频时长,支持 2–30 之间的整数秒。 |
| resolution | string | 否 | 720p | 分辨率枚举值,可选 480p、720p 或 1080p。 |
| aspect_ratio | string | 否 | adaptive | 画面比例,可选 adaptive(自适应参考)、16:9、4:3、1:1、3:4 或 9:16。 |
| audio | boolean | 否 | true | 是否伴随视频生成原生同步音轨,开启与关闭同价。 |
| seed | integer | 否 | - | 随机种子值(0–2,147,483,647),固定种子有助于重现类似走势。 |
| enable_safety_checker | boolean | 否 | true | 是否开启安全审查过滤。 |
响应字段(查询结果)
通过 GET /api/generate/status/{task_id} 轮询获取的任务详情:
| 字段 | 类型 | 描述 |
|---|---|---|
| code | integer | 业务响应状态码,200 表示成功。 |
| data.task_id | string | 异步任务全局唯一流水号。 |
| data.status | string | 任务执行阶段:not_started(排队中)、running(生成中)、finished(已完成)、failed(失败)。 |
| data.files | array | 生成成功时包含的成片文件列表,每项含 file_url 与 file_type。 |
| data.error_message | string | null | 任务执行异常时的具体错误描述。 |
任务生命周期
客户端应根据 status 字段判断任务进度,达到 finished 或 failed 终态时立即终止轮询:
not_started任务已提交,系统正在并行下载并解析输入的图片、视频、音频或文档资产。
running计算节点正在执行全模态跨素材特征对齐、扩散去噪计算与音轨渲染。
finished视频已生成并上传持久化存储,可从 data.files[0].file_url 获取播放及下载地址。
failed任务因素材下载失败、参数互斥校验不通过或安全审核终止,读取 data.error_message 获知原因。
轮询与异常处理
- 轮询频次推荐由于多模态素材下载与预解析耗时,建议提交后等待 3 秒开始首次轮询,后续每 3–5 秒查询一次。
- 参数互斥保护若同时传入了 reference_file_urls 和 reference_link_urls,接口将返回 400 校验错误并中止执行。
- 异步 Webhook 回调支持在提交请求体根层级传递 callback_url,在任务终态时系统将通过 POST 自动推送完整任务结果。
接口规格
| 规格项 | 取值 | 说明 |
|---|---|---|
| 模型标识 | alibaba/wan-3.0/reference-to-video | 请求体 model 字段传递的 API 调用路由标识。 |
| 输入模式 | 多模态参考资产(合计 ≤ 20 项) | 图片 ≤10,视频 ≤5,音频 ≤5,文档或网页 ≤1(互斥二选一),并配合文本提示词。 |
| 输出规格 | 30 fps / MP4 (H.264) | 标准 MP4 视频容器,内嵌 AAC 编码原生同步音轨。 |
| 单次时长 | 2–30 秒 | 支持在 2 到 30 秒闭区间内按整秒自由设置生成时长。 |
| 原生分辨率 | 480p / 720p / 1080p | 可选标清、高清与全高清三档原生输出分辨率,默认 720p。 |
Wan 3.0 Reference-to-Video
Wan 3.0 Reference-to-Video 由阿里通义实验室研发,支持引入多张图片、视频片段、音频、PPT/PDF文档或网页作为引导资产,结合自然语言提示词生成全新高清视频。它能够在单次 2–30 秒的生成中跨场景保持角色容貌、服饰设计与艺术风格的高度一致,并根据参考资产直接合成原生同步音轨。
为什么选择此模式?
全模态参考资产输入单次请求支持组合引入图片(最多 10 张)、视频(最多 5 段)、音频(最多 5 段)以及 PPT/PDF 文档或公开网页,资产总数可达 20 项。
高保真角色与风格一致性通过跨素材特征对齐,长效锁定主角面容、服装细节与特定艺术渲染质感,满足连续剧集与长线 IP 创作需求。
文档与网页智能提炼支持直接传入 1 份结构化文档(PPT/PDF/DOC等)或公开网页链接,自主理解图文要点并转化为连贯的解说动态视频。
原生音画全模态联合生成根据输入的参考音频音色或画面动作意图,由扩散模型底层直接合成匹配环境底噪与动作声效的 30 fps 高清视频。
长达 30 秒 1080p 成片支持 2–30 秒整秒时长及最高 1080p 原生分辨率,满足影视分镜、广告提案与社交自媒体专业交付标准。
参数说明
| 参数 | 要求 | 说明 |
|---|---|---|
| prompt | 必填 | 字符串。详细描述创作目标、各参考资产的角色定位、时序动作与镜头语言;去除首尾空格后支持 1–20,000 个字符。 |
| reference_image_urls | 可选 | 字符串数组。用于提供角色肖像、场景设定或道具图,最多支持 10 张;单张图片不超过 30MB,支持 JPEG、PNG 和 WebP。 |
| reference_video_urls | 可选 | 最多 5 个公开 HTTP(S) 参考视频 URL,用于引导动作、运镜或节奏。 |
| reference_audio_urls | 可选 | 字符串数组。用于提供音色参考、对白节奏或环境声源,最多支持 5 个;单个文件不超过 50MB,支持 MP3、WAV 格式。 |
| reference_file_urls | 可选 | 最多 1 个公开 HTTP(S) 文档 URL,与 reference_link_urls 互斥。 |
| reference_link_urls | 可选 | 字符串数组。最多包含 1 个免登录公开网页 URL;与 reference_file_urls 互斥。 |
| duration | 可选 | 整数。设置生成视频的时长,取值范围为 2–30 秒;体验区默认预设为 5 秒。 默认值 5 |
| resolution | 可选 | 字符串。指定输出视频的分辨率规格;可选 480p、720p(默认)或 1080p。 默认值 720p480p1080p |
| aspect_ratio | 可选 | 字符串。控制画面长宽比例;支持 adaptive(自适应参考素材)、16:9、4:3、1:1、3:4 和 9:16。 默认值 adaptive16:94:31:13:49:16 |
| audio | 可选 | 布尔值。控制是否同时生成与画面匹配的原生同步音频;默认为 true,与无音频输出同价。 默认值 truefalse |
| seed | 可选 | 整数。随机数种子,取值范围为 0–2,147,483,647;固定种子有助于复现相似动态走势。 |
| enable_safety_checker | 可选 | 布尔值。开启后对生成内容执行安全合规校验;默认为 true。 默认值 truefalse |
使用方法
准备并上传参考素材根据创作目的选择素材:可上传主角正面/侧面图片(最多 10 张)、动态动作参考视频(最多 5 个)、音色音频,或选择上传一份商业 PPT 文档/输入网页链接。
在提示词中明确分配资产角色使用清晰的代词指引模型关注特定素材,例如:以参考图1的人物作为主角,结合参考图2的机械手套道具,在参考图3设定的未来实验室内活动。
细化剧情发展与运镜轨迹按时间顺序说明故事动作推进,并指定镜头语言,例如:主角缓步走向实验台拿起道具,镜头顺畅环绕并切入特写。
设置时长与分辨率规格根据叙事复杂度设定 2–30 秒的时长,选择 720p 或 1080p 分辨率,若素材包含特定画幅可将画面比例设为 adaptive 或 16:9。
检查声音与资产互斥限制确认保持音频生成开关开启以合成匹配音轨;若传入文档,请确认未同时传入网页链接。
提交生成并获取高保真成片点击立即生成提交异步请求,在右侧渲染控制台跟踪状态并在完成后直接播放、核验角色一致性与下载视频。
计费说明
Wan 3.0 Reference-to-Video 按实际生成的成片秒数计费,费率仅由选择的分辨率决定;多模态参考素材的上传解析与音频合成不产生额外附加费(1 积分 = $0.005)。
| 计费项 | 费率 | 说明 |
|---|---|---|
| 480p | 10 积分 / 输出秒($0.05 / 秒) | 基础高清规格。生成默认 5 秒为 50 积分($0.25);生成最长 30 秒为 300 积分($1.50)。 |
| 720p(默认) | 20 积分 / 输出秒($0.10 / 秒) | 主流高清规格。生成默认 5 秒为 100 积分($0.50);生成最长 30 秒为 600 积分($3.00)。 |
| 1080p | 40 积分 / 输出秒($0.20 / 秒) | 旗舰全高清规格。生成默认 5 秒为 200 积分($1.00);生成最长 30 秒为 1200 积分($6.00)。 |
适用场景
IP 角色跨场景连续故事创作输入主角三视图与服饰参考图,在不同背景下生成角色动作连贯、面部恒定的 2–30 秒短剧分镜。
PPT 文档与方案动态解说上传商业提案、培训课件或产品发布 PDF/PPT,自动提取核心图文并转化为配有画外音氛围的宣讲视频。
新闻资讯与网页内容视频化输入公开文章或产品落地页链接,模型自动提炼文字结构生成图文并茂的短视频动态资讯。
指定动作与动态风格迁移输入已有动作视频片段与新的角色肖像图,引导模型将角色的运动姿态与镜头运动迁移至新角色成片中。
创作技巧
- 多角度素材构建完整立体特征:提供 2–3 张主角在不同光影、正面与半侧面视角下的参考图片,能够大幅增强角色在转身走动时的形体稳定性。
- 在提示词中精确建立资产绑定:使用“参考图1的主角穿着参考图2的机能外套”等明确绑定短语,避免多资产组合时特征相互混淆。
- 遵守文档与网页的互斥规则:单次任务中,文档(reference_file_urls)与网页(reference_link_urls)二选一,请勿在同一请求中同时传入两者。
- 文档内容保持清晰:突出核心图表和正文层次,便于提取重点并安排视频叙事。
- 分镜头长故事制作策略:制作多镜头短剧时,建议使用固定的参考图片集生成各个分镜头,再进行串联剪辑,实现全片视觉高度统一。
注意事项
- 参考素材总量上限:单次请求中所有参考资产总数不得超过 20 项(图片最多 10 张,视频最多 5 段,音频最多 5 段,文档/网页最多 1 项)。
- 文档与网页互斥约束:reference_file_urls 与 reference_link_urls 属于互斥参数,同一任务只能指定其中一种。
- 整秒时长设定:duration 参数接受 2–30 之间的整数秒,请勿传递浮点数或超出该区间的数值。
Wan 3.0 Reference-to-Video API — 常见问题
Wan 3.0 Reference-to-Video API 是什么?
Wan 3.0 Reference-to-Video 是阿里通义实验室研发的全模态参考生成视频模型。它支持组合文本提示词与图片、视频、音频、结构化文档或公开网页链接(总计多达 20 项参考资产),生成最长 30 秒、最高 1080p 的原生音画同步视频。基于多模态对齐与 Diffusion Transformer 架构,它能够跨镜头精准继承角色的面容外观、动作姿态或文档核心内容,实现高一致性的全新场景创作。你可以通过 API 进行程序化调用,也可以在上方体验区直接在线试用。
Wan 3.0 参考生视频能直接上传 PPT 或 PDF 出片吗?
可以。在 reference_file_urls 中传入一份结构化文档链接(支持 PPT、PPTX、PDF、DOCX、TXT、MD 等格式),模型能自动解析文档的图文结构与排版逻辑,并结合提示词转化为包含解说声场与动态运镜的专业讲解视频。
Wan 3.0 参考生视频能同时使用文档与网页链接吗?
不能。结构化文档(reference_file_urls)与网页链接(reference_link_urls)存在互斥约束,单次任务中只能二选一传入其一(最多 1 个)。如需补充更多视觉或声音参考,可搭配使用参考图片、视频或音频素材。
Wan 3.0 参考生视频最多支持传入几份参考资产?
单次调用总共支持传入最多 20 项素材组合,具体包括:最多 10 张参考图片、最多 5 个参考视频、最多 5 段参考音频,以及最多 1 个文档或网页链接。多素材组合极大丰富了复杂故事的创作灵活性。
如何在提示词中对 Wan 3.0 参考生视频的多主体进行点名?
建议使用分工指代语法,例如在提示词中写清“使用参考图 1 确定主角面容与风衣,使用参考图 2 确定手持道具,使用参考视频 1 引导行走步伐”。精准的点名指代能让模型将不同素材的特征分别绑定到对应实体。
传入参考音频后 Wan 3.0 参考生视频如何处理声音?
当传入 reference_audio_urls 时,模型会提取参考音频的音色、语调或旋律节奏,并将其与视频画面的主体动作、口型动态及环境底噪有机融合,生成音画节奏自然契合的视听成片。
如何提供文档参考?
在 reference_file_urls 中提供一个公开可访问的 HTTP(S) 文档 URL,不要同时提供 reference_link_urls。