Preserve the adult performer, red costume, two silks and empty circus tent from the image. Securely supported in the hip wrap, she slowly rotates a quarter turn; free silk tails follow with realistic weight. A gentle camera arc follows without cutting. Keep natural anatomy and finish in a stable held pose. Audio: soft breathing, silk friction and quiet tent ambience; no music or speech. No text, logos or watermarks.
Kling O3 Standard Image to Video API
kwaivgi/kling-video-o3-std/image-to-videoKling O3 Standard 图生视频:使用首帧和可选尾帧生成 3–15 秒视频。支持单镜头和多镜头;sound 必须显式传入,多镜头必须开启声音。
输入
410/2,500
Image Urls[0]
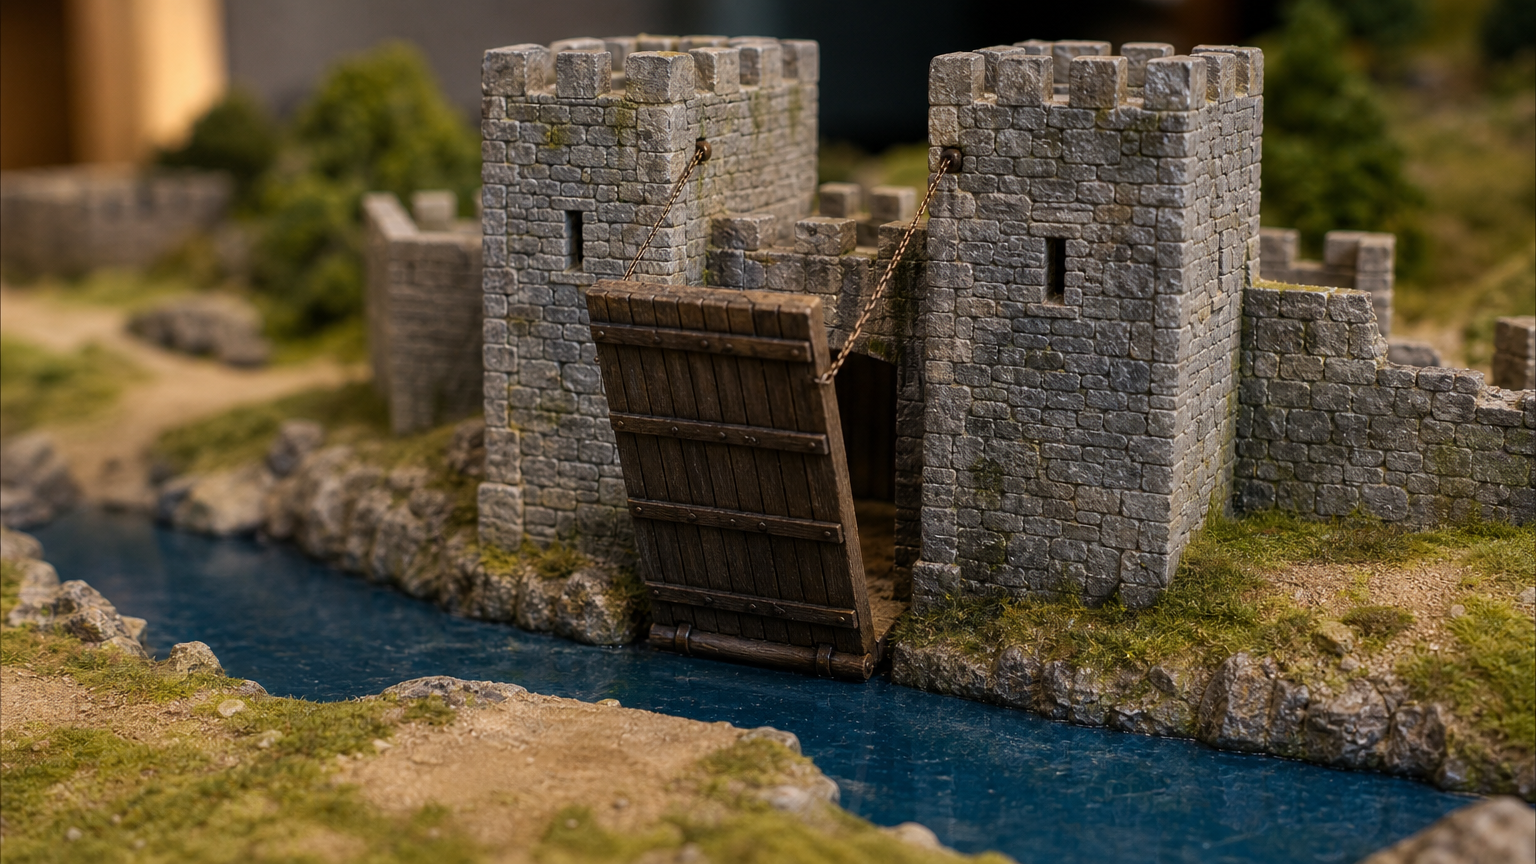
Image Urls[1](可选)
](https://cdn.vidgo.ai/apis/models/kwaivgi/kling-video-o3-std/image-to-video/v1/03/input-end.png)
输出
已就绪继续使用
示例
REST API 规格
快速开始
提交任务并查询状态。
01
第一步:配置 API 鉴权
在控制台创建 API Key,提交请求时附带 Authorization: Bearer <API_KEY>。
- 任务提交端点
- POST
https://api.vidgo.ai/api/generate/submit - 鉴权请求头
- Authorization: Bearer VIDGO_API_KEY
02
第 2 步:提交任务
POST /api/generate/submit: kwaivgi/kling-video-o3-std/image-to-video
提交请求载荷
REQUEST_BODY=$(cat <<'JSON'
{
  "model": "kwaivgi/kling-video-o3-std/image-to-video",
  "input": {
    "duration": 3,
    "sound": false,
    "multi_shots": false,
    "prompt": "Fixed-camera miniature scene. Move from the supplied raised-drawbridge start frame to the lowered-drawbridge end frame. The single rigid wooden bridge slowly rotates down around its bottom hinge at the doorway until it reaches the opposite bank; both chains extend naturally. Preserve the towers, moat, tabletop, lighting and framing. No people, new structures or camera movement. No text, logos or watermarks.",
    "image_urls": [
      "https://cdn.vidgo.ai/apis/models/kwaivgi/kling-video-o3-std/image-to-video/v1/03/input-start.png",
      "https://cdn.vidgo.ai/apis/models/kwaivgi/kling-video-o3-std/image-to-video/v1/03/input-end.png"
    ]
  }
}
JSON
)

RESPONSE=$(curl --silent --show-error --fail-with-body \
  --request POST \
  --url "https://api.vidgo.ai/api/generate/submit" \
  --header "Authorization: Bearer $VIDGO_API_KEY" \
  --header "Content-Type: application/json" \
  --data "$REQUEST_BODY")

CODE=$(printf '%s' "$RESPONSE" | jq -r '.code // empty')
if [ "$CODE" != "0" ] && [ "$CODE" != "200" ]; then
  printf 'API error: %s
' "$RESPONSE" >&2
  exit 1
fi
printf '%s
' "$RESPONSE"
03
第三步:轮询任务执行结果
使用 task_id 查询进度;not_started 或 running 时继续轮询,finished 或 failed 时停止。成功后读取 data.files[].file_url,失败时读取 data.error_message。
状态查询端点
GET https://api.vidgo.ai/api/generate/status/{task_id}使用 task_id 查询进度;not_started 或 running 时继续轮询,finished 或 failed 时停止。成功后读取 data.files[].file_url,失败时读取 data.error_message。
not_startedrunningfinishedfailed提交响应结果
{
  "code": 200,
  "data": {
    "task_id": "task-submitted-example",
    "status": "not_started",
    "created_time": "2026-09-22T00:00:00Z"
  }
}
完成响应数据
{
  "code": 200,
  "data": {
    "task_id": "97JVN8DM9N5UJLYO",
    "status": "finished",
    "files": [
      {
        "file_type": "video",
        "file_url": "https://cdn.vidgo.ai/apis/models/kwaivgi/kling-video-o3-std/image-to-video/v1/03/output.mp4"
      }
    ],
    "created_time": "2026-09-22T18:58:33",
    "error_message": null,
    "progress": 100
  }
}
端到端完整脚本示例
展开查看在生产环境中具备轮询重试、异常保护和超时处理的完整自动化脚本。
端到端完整脚本示例
set -euo pipefail
: "${VIDGO_API_KEY:?Set VIDGO_API_KEY in your environment}"

REQUEST_BODY=$(cat <<'JSON'
{
  "model": "kwaivgi/kling-video-o3-std/image-to-video",
  "input": {
    "duration": 3,
    "sound": false,
    "multi_shots": false,
    "prompt": "Fixed-camera miniature scene. Move from the supplied raised-drawbridge start frame to the lowered-drawbridge end frame. The single rigid wooden bridge slowly rotates down around its bottom hinge at the doorway until it reaches the opposite bank; both chains extend naturally. Preserve the towers, moat, tabletop, lighting and framing. No people, new structures or camera movement. No text, logos or watermarks.",
    "image_urls": [
      "https://cdn.vidgo.ai/apis/models/kwaivgi/kling-video-o3-std/image-to-video/v1/03/input-start.png",
      "https://cdn.vidgo.ai/apis/models/kwaivgi/kling-video-o3-std/image-to-video/v1/03/input-end.png"
    ]
  }
}
JSON
)

SUBMIT_RESPONSE=$(curl --silent --show-error --fail-with-body \
  --request POST \
  --url "https://api.vidgo.ai/api/generate/submit" \
  --header "Authorization: Bearer $VIDGO_API_KEY" \
  --header "Content-Type: application/json" \
  --data "$REQUEST_BODY")

TASK_ID=$(printf '%s' "$SUBMIT_RESPONSE" | jq -r '.data.task_id // .task_id // empty')
BUSINESS_CODE=$(printf '%s' "$SUBMIT_RESPONSE" | jq -r '.code // empty')
if [ "$BUSINESS_CODE" != "0" ] && [ "$BUSINESS_CODE" != "200" ]; then
  printf 'Submit failed:
%s
' "$SUBMIT_RESPONSE" >&2
  exit 1
fi
if [ -z "$TASK_ID" ]; then
  printf 'Submit response did not include task_id:
%s
' "$SUBMIT_RESPONSE" >&2
  exit 1
fi

START_TIME=$(date +%s)
POLL_DELAY=2
while true; do
  if [ $(( $(date +%s) - START_TIME )) -ge 600 ]; then
    printf 'Timed out after 600 seconds
' >&2
    exit 1
  fi
  STATUS_RESPONSE=$(curl --silent --show-error --fail-with-body \
    --url "https://api.vidgo.ai/api/generate/status/$TASK_ID" \
    --header "Authorization: Bearer $VIDGO_API_KEY")
  STATUS=$(printf '%s' "$STATUS_RESPONSE" | jq -r '.data.status // .status // empty')
  BUSINESS_CODE=$(printf '%s' "$STATUS_RESPONSE" | jq -r '.code // empty')
  if [ "$BUSINESS_CODE" != "0" ] && [ "$BUSINESS_CODE" != "200" ]; then
    printf 'Status request failed:
%s
' "$STATUS_RESPONSE" >&2
    exit 1
  fi

  case "$STATUS" in
    finished)
      printf '%s' "$STATUS_RESPONSE" | jq -r '(.data.files // .files // [])[]?.file_url'
      break
      ;;
    failed)
      printf '%s' "$STATUS_RESPONSE" | jq -r '.data.error_message // .error_message // "Generation failed"' >&2
      exit 1
      ;;
    not_started|running)
      sleep "$POLL_DELAY"
      if [ "$POLL_DELAY" -lt 10 ]; then POLL_DELAY=$((POLL_DELAY + 1)); fi
      ;;
    *)
      printf 'Unexpected task status: %s
' "$STATUS" >&2
      exit 1
      ;;
  esac
done
请求参数(input 对象)
生成参数放在 input 中。建议使用标准 JSON 数字和布尔值。兼容 "5" 这样的整数字符串。布尔字符串 true/1/yes/y/on 表示 true,false/0/no/n/off 表示 false,不区分大小写并忽略首尾空白;布尔字段也接受数值 1 和 0。提示词中的数字和布尔值会转为文本,0、false 和 null 按空值处理;对象和数组不能作为提示词。 提示词的 API 校验上限为 2,500 字符。部分多镜头生成请求曾因单段提示词超过 512 字符而失败,建议每段控制在 512 字符以内;这项建议不改变 API 校验上限。
| 字段 | 类型 | 必填 | 默认值 | 描述 |
|---|---|---|---|---|
| prompt | string | 条件必填 | - | multi_shots=false 时必填,描述场景、动作和镜头运动。去除首尾空白后须为非空文本,最多 2,500 字符。multi_shots=true 时请省略 prompt。 |
| multi_shots | boolean | 是 | - | 必填,必须显式传入 false(单镜头)或 true(多镜头)。单镜头需要 prompt;多镜头需要 multi_prompt 和 sound=true,且顶层 prompt 不得为非空文本。省略此字段会报错。 |
| multi_prompt | array | 条件必填 | - | multi_shots=true 时必填,单镜头模式请省略。至少提供一个分镜,每段包含非空 prompt(最多 2,500 字符)和整数 duration(1–12 秒)。分镜时长之和必须等于顶层 duration(3–15 秒)。分镜内的额外字段会被忽略。 |
| duration | integer | 是 | - | 必填,3–15 秒的整数。多镜头模式下必须等于所有分镜时长之和,积分按此值计算。 |
| sound | boolean | 是 | - | 必填,必须显式传入 true(生成声音)或 false(无声视频)。单镜头可使用任一值,多镜头必须为 true。 |
| aspect_ratio | string | 否 | - | 可省略;若传入,仅接受 16:9、9:16 或 1:1。图生会忽略该值,实际画幅由输入图片决定。 |
| image_urls | array | 是 | - | 必填,包含 1–2 张图片的数组,第一张为首帧,第二张为可选尾帧。支持公开 HTTP(S) URL、图片 Data URI 或原始 Base64 图片数据。 |
响应字段(查询状态接口)
GET /api/generate/status/{task_id} 接口返回的详细参数说明:
| 字段 | 类型 | 描述 |
|---|---|---|
| code | integer | 接口响应状态码(200 表示成功)。 |
| data.task_id | string | 全局唯一的生成任务标识符。 |
| data.status | string | 任务执行阶段:not_started(排队)、running(处理中)、finished(已完成)或 failed(失败)。 |
| data.files | array | 生成成功时返回的媒体资产列表,包含 file_url 与 file_type。 |
| data.error_message | string | null | 当任务失败时返回的具体诊断错误信息。 |
任务生命周期
客户端应持续轮询任务状态,直至进入 finished 或 failed 终态:
not_started排队中
running生成中
finished已就绪
failed失败
轮询与异常处理
- 轮询频率建议建议提交任务后前 10 秒每隔 2-3 秒轮询一次,之后可适度放缓至 5 秒一次。
- 网络容错设计遇到临时网络抖动或网关 5xx 错误时不要重新提交任务,应使用原 task_id 继续轮询重试。
- 回调机制(Webhook)支持在提交请求体根层级传递 callback_url,在任务终态时系统将通过 POST 自动推送完整任务结果。
接口规格
| 规格项 | 取值 | 说明 |
|---|---|---|
| 模型 | kwaivgi/kling-video-o3-std/image-to-video | 快手可灵 O3 原生多模态图生视频标准版,支持单图首帧驱动与首尾双关键帧 720p 物理插值生成。 |
| 时长 | 3-15 s | 必填,3–15 整数秒。多镜头时必须等于各分镜时长之和,按此时长计费。 |
Kling O3 Standard Image to Video
Kling O3 Standard 图生视频:使用首帧和可选尾帧生成 3–15 秒视频。支持单镜头和多镜头;sound 必须显式传入,多镜头必须开启声音。
为什么选择此模型
首尾双关键帧控制支持上传起始帧与结束帧两张图片,模型依据物理动力学自动插值过渡轨迹,精确掌控视频始末状态。
出色的视觉特征继承深度锁定源图中的人物面部五官、服装纹理与场景纵深结构,动态演绎中无漂移、不畸变。
原生动作音效合成结合图像画面语义与动态轨迹,原生合成伴随动作发生的环境音响与碰撞音效,音随画动。
高效 720p 动态表现以 10 积分/秒的亲民成本输出高质量 720p 动态成片,特别适合图生视频大批量流水线生产。
多镜头分镜与时长自由支持 3–15 秒整秒输出与多镜头序列控制,赋予静态图片丰富的影视叙事延展空间。
参数说明
| 参数 | 要求 | 说明 |
|---|---|---|
| prompt | 条件必填 | multi_shots=false 时必填,描述场景、动作和镜头运动。去除首尾空白后须为非空文本,最多 2,500 字符。multi_shots=true 时请省略 prompt。 默认值 - |
| multi_shots | 是 | 必填,必须显式传入 false(单镜头)或 true(多镜头)。单镜头需要 prompt;多镜头需要 multi_prompt 和 sound=true,且顶层 prompt 不得为非空文本。省略此字段会报错。 默认值 - |
| multi_prompt | 条件必填 | multi_shots=true 时必填,单镜头模式请省略。至少提供一个分镜,每段包含非空 prompt(最多 2,500 字符)和整数 duration(1–12 秒)。分镜时长之和必须等于顶层 duration(3–15 秒)。分镜内的额外字段会被忽略。 默认值 - |
| duration | 是 | 必填,3–15 秒的整数。多镜头模式下必须等于所有分镜时长之和,积分按此值计算。 默认值 - |
| sound | 是 | 必填,必须显式传入 true(生成声音)或 false(无声视频)。单镜头可使用任一值,多镜头必须为 true。 默认值 - |
| aspect_ratio | 否 | 可省略;若传入,仅接受 16:9、9:16 或 1:1。图生会忽略该值,实际画幅由输入图片决定。 默认值 - |
| image_urls | 是 | 必填,包含 1–2 张图片的数组,第一张为首帧,第二张为可选尾帧。支持公开 HTTP(S) URL、图片 Data URI 或原始 Base64 图片数据。 默认值 - |
使用步骤
上传源参考图像提供 1 张起始帧图片(必选);如需精准控制收尾状态,可再上传 1 张结束帧图片。
描述动态意图撰写运动提示词,交代人物动作、相机运镜方向以及场景内的环境动态变化。
设定时长与音频选择 3–15 秒的成片时长,并根据内容需要开启或关闭原生同步音频开关。
提交生成任务发起 API 调用或点击运行,系统根据首尾关键帧约束与提示词指导开始物理时空推理。
预览与导出视频任务完成后在线播放审查生成的 720p 动态视频,确认动作平滑度并导出保存。
价格
费用 = 顶层 duration × 每秒费率。1 积分 = $0.005。任务若执行失败,系统将全额自动返还扣除的积分。
| 计费项 | 费率 | 说明 |
|---|---|---|
| 无声 | 10 积分/秒 ($0.050/s) | 文生视频与图生视频使用相同费率。 |
| 有声 | 13 积分/秒 ($0.065/s) | 文生视频与图生视频使用相同费率。 |
适用场景
静帧摄影动态升维将高质量人像摄影或风光静帧转化为生动的 720p 动态短片,用于艺术画廊展示。
电商静态商品展示生活上传服装模特或数码商品图,生成衣物摆动、水流倾泻等生动展示视频。
首尾帧精准过渡运镜传入场景俯瞰图与特写图作为首尾帧,由模型自动插值生成平滑的变焦推拉镜头。
动漫插画微动化激活二维插画与概念设定图,赋予角色眨眼、发丝飘动与背景动态光影。
使用技巧
- 提供 2 张图片时,首张作为视频首帧,第二张作为视频尾帧,两张图的构图逻辑与主体比例尽量保持合理物理演化间距。
- 提示词重点描述“从首帧状态过渡到尾帧状态的具体动作路径”,例如“角色缓缓转头望向镜头并露出微笑”。
- 源图片建议使用清晰、无过度压缩的 JPEG 或 PNG 格式,画面核心主体处于视觉中心。
- 如需生成角色说话视频,上传清晰面部特写并在提示词中注明台词内容,同时开启声音选项。
- 运动幅度建议遵循物理惯性,避免提示词中出现与初始画面物理姿态冲突的瞬间突变动作。
注意事项
- image_urls 数组支持 1–2 个公开 HTTP(S) 地址或合法的 Base64 图片数据,首图为起幅,次图为落幅。
- 开启多镜头模式时,顶层 prompt 须为空,所有描述配置在 multi_prompt 中,且必须启用 sound=true。
- 任务执行采用异步处理流程,请使用返回的 task_id 查询任务状态直到变为 finished 或 failed。
Kling O3 Standard Image to Video API 常见问题
这个端点可以生成什么?
Kling O3 Standard 图生视频:使用首帧和可选尾帧生成 3–15 秒视频。支持单镜头和多镜头;sound 必须显式传入,多镜头必须开启声音。
如何使用首帧和尾帧?
必填,包含 1–2 张图片的数组,第一张为首帧,第二张为可选尾帧。支持公开 HTTP(S) URL、图片 Data URI 或原始 Base64 图片数据。
视频画幅如何确定?
可省略;若传入,仅接受 16:9、9:16 或 1:1。图生会忽略该值,实际画幅由输入图片决定。
如何设置多镜头?
必填,必须显式传入 false(单镜头)或 true(多镜头)。单镜头需要 prompt;多镜头需要 multi_prompt 和 sound=true,且顶层 prompt 不得为非空文本。省略此字段会报错。 multi_shots=true 时必填,单镜头模式请省略。至少提供一个分镜,每段包含非空 prompt(最多 2,500 字符)和整数 duration(1–12 秒)。分镜时长之和必须等于顶层 duration(3–15 秒)。分镜内的额外字段会被忽略。
如何控制声音和提示词长度?
必填,必须显式传入 true(生成声音)或 false(无声视频)。单镜头可使用任一值,多镜头必须为 true。 提示词的 API 校验上限为 2,500 字符。部分多镜头生成请求曾因单段提示词超过 512 字符而失败,建议每段控制在 512 字符以内;这项建议不改变 API 校验上限。
时长和积分如何计算?
时长为 3–15 秒。无声视频 10 credits/秒,有声视频 13 credits/秒;积分为顶层 duration 乘以对应费率。
生成失败或请求超时怎么办?
非法参数会在创建生成任务和扣费前被拒绝。已受理的生成任务状态变为 failed 后,已扣积分会退回。客户端超时不代表任务失败,请先查询原 task_id 的状态,再决定是否重新提交。