Wan 2.7 Image Text to Image API

alibaba/wan-2.7/text-to-image
6 种预设尺寸 / 自定义尺寸 · 1–4 张

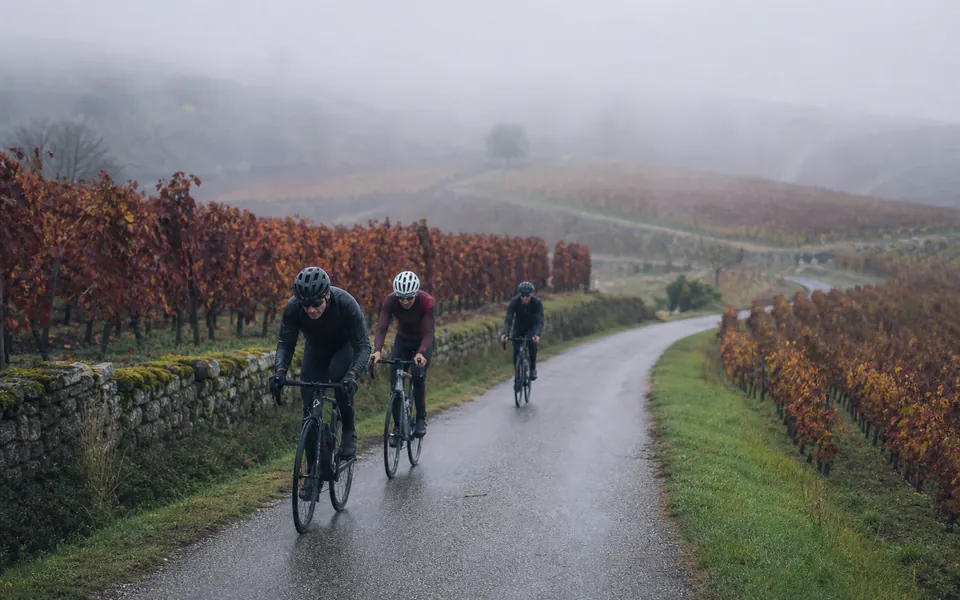
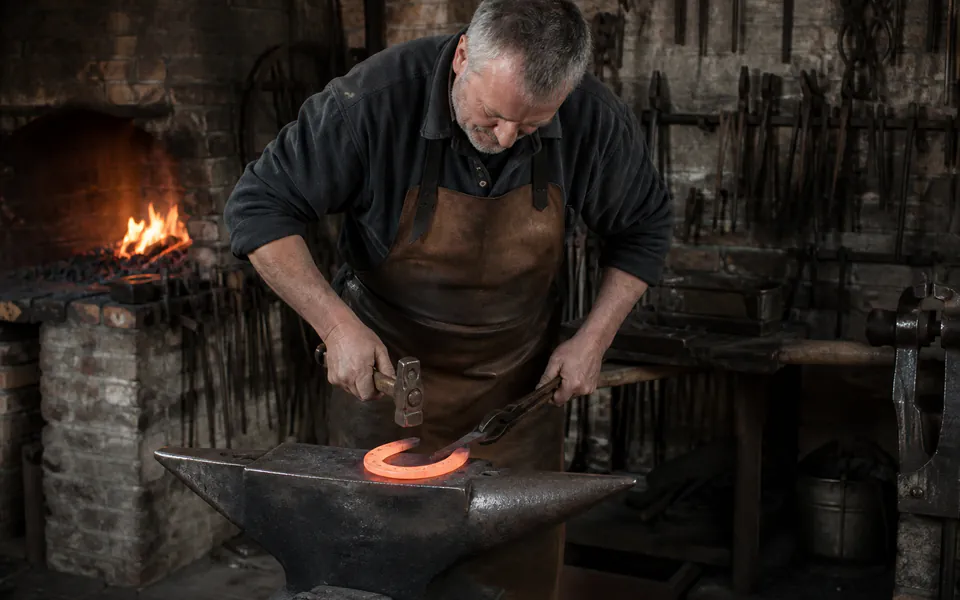
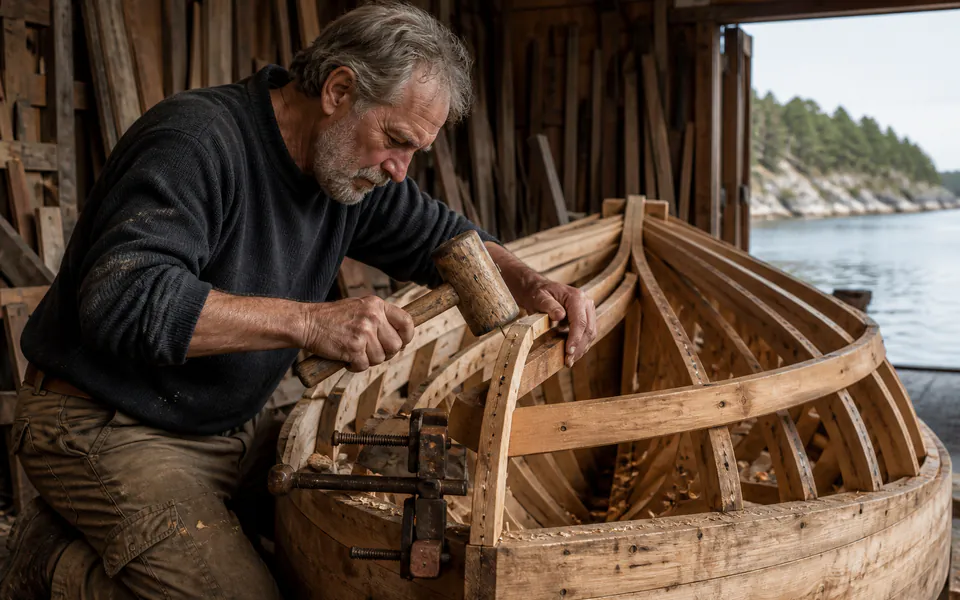
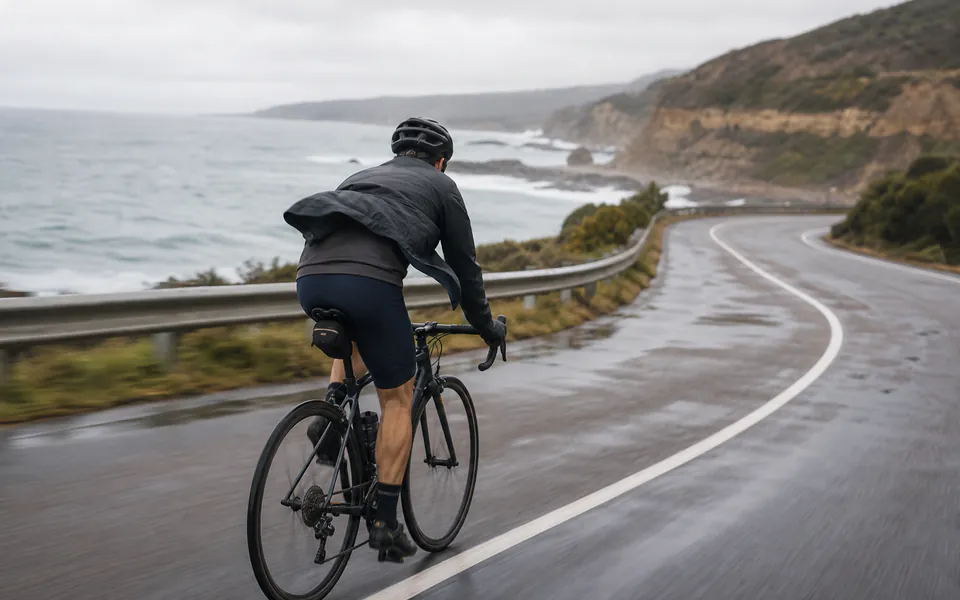
Wan 2.7 Image Text to Image 将自然语言提示词转化为高保真 1K 与 2K 图像,支持 Thinking Mode 构图推理、中英双语字体排版渲染与色板精确控色。它在严格遵循提示词物理规律与空间关系的同时,呈现细腻逼真的光影质感与丰富细节。

获取 API Key
输入
716/5000
输出已就绪
1 × 4.2 = 4.2 积分 · $0.021

继续使用

示例

standard-text-01-output

Photorealistic quiet old railway waiting room, warm late-afternoon sunlight, worn wooden benches and cream plaster. A large dark green timetable board is the main focal point, nearly front-facing and occupies half the frame. Render ONLY these five lines of crisp, large, correctly spelled lettering on the board: "列车时刻 / TIMETABLE", "松林 / PINES 08:20", "湖畔 / LAKESIDE 10:45", "山谷 / VALLEY 16:30", "一路平安 / SAFE JOURNEY". Carefully aligned rows with consistent spacing, all lettering readable. Authentic painted enamel, subtle scratches, dust in the light, cinematic but restrained composition. No other visible text, people, promotional graphics or extra boards. No advertising, brands, logos, watermark, or foxes.

standard-text-02-output

Natural wildlife photograph at eye level of one roseate spoonbill foraging in a salt marsh. Its long flattened spoon-shaped bill touches the shallow water; anatomically correct slender legs and layered pale pink feathers, subtle crimson shoulder patch. One bird only, no duplicates. Pale salt grasses, small ripples and a coherent reflection, layered muted blue-green estuary in the distance. Soft overcast morning light and delicate feather detail, unposed natural behavior. No writing. No advertising, brands, logos, watermark, or foxes.
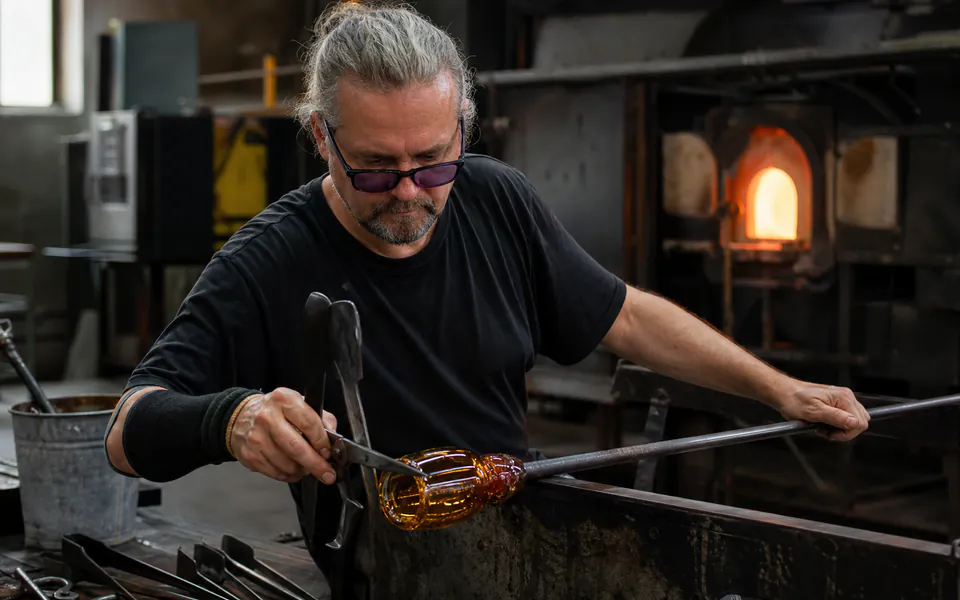
standard-text-03-output

Candid documentary portrait of a silver-haired woman in her seventies considering a chess move at an outdoor stone chess table in a leafy neighborhood square. Distinctive deep smile lines, short wavy white hair, ochre cardigan, natural skin texture. Her right hand gently holds one wooden knight between thumb and index finger above the board; her left rests on the edge of the table. Believable fingers and wrists, restrained thoughtful expression. Green plane-tree shade with soft sunlight, intimate waist-up composition, no other people or text. No advertising, brands, logos, watermark, or foxes.
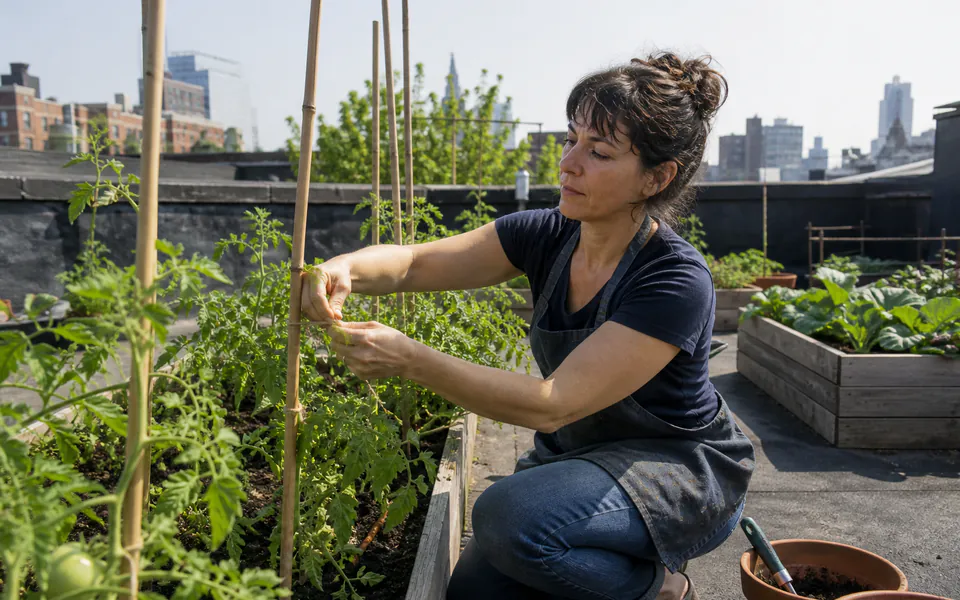
Wan 2.7 Image Text to Image 概览

Wan 2.7 Image Text to Image 是由阿里通义实验室研发的高性能文本生成图像模型。模型采用多模态规划器与扩散变换器(DiT)联合架构,在生成前期通过内置思维链深入解析复杂物体的空间布局与提示词意图。它支持 6 种预设比例及自定义像素分辨率,并在多行清晰文字渲染、品牌指定色系控制与真实人像质感方面表现卓越,满足概念设计、广告海报与自媒体配图的高频生成需求。

为什么选择

  • Thinking Mode 深度空间推理内置思维链推理阶段,在合成前主动分析多物体交互、空间层级与遮挡关系,即使面对多角色或复杂场景提示词也能确保构图严谨。

  • 中英双语复杂排版文字渲染攻克 AI 绘图文字扭曲难题,支持在画面中直接渲染清晰、端正的多行中英文字符、标语与品牌文案,边缘清晰锐利。

  • 色板引导精准调色与极端画幅原生支持通过十六进制色值指定主色调分布,并全面适配 1:8 至 8:1 极端画幅比例,轻松驾驭全景横幅与长条展示屏。

参数

参数要求说明
prompt必填

字符串,去除首尾空白后 1–5,000 字符。详细描述画面主体、场景风格、文字内容与光影色调。

size可选

六种预设尺寸,或 {"width":1280,"height":720} 对象。宽高必须为正整数。

默认1024x1024512x512768x10241024x768576x10241024x576
n可选

生成图片数量,整数 1–4。费用 = 单张积分 × n。

默认1
seed可选

可选整数,不提供时不发送该字段。用于复现相似的画面构图与视觉特征。

使用方法

  1. 构造提示词与排版内容输入详尽的画面描述,若需要生成文字可使用双引号包裹中英文文案,或指定色调色系。

  2. 配置尺寸与张数按展示场景选择预设画幅比例或自定义像素尺寸,设置 1 至 4 张输出数量。

  3. 提交异步任务并获取结果通过统一端点提交任务,轮询 task_id 状态至完成即可读取高清图片下载链接。

价格

每张 4.2 积分($0.021)。总积分 = 4.2 × n。尺寸和参考图数量不额外计费。1 积分 = $0.005。

用量费率详情
Standard4.2 积分/张 · $0.021按输出数量 n 计费,失败任务退还积分。

适用场景

  • 商业广告与社媒海报直接在画面中排布清晰中文与英文营销标语,一键生成符合品牌色板的高清视觉物料。

  • 电商产品背景与场景概念图根据文本要求规划空间透视与光线反射,快速产出逼真的商品陈列与生活场景图。

  • 全景横幅与数字艺术创作利用 1:8 至 8:1 极限画幅能力制作网页长 Banner、移动端长图与概念视觉原画。

使用建议

  • 精准渲染文字技巧:在提示词中使用半角双引号明确标出文字内容(例如 海报正中央写着 "SUMMER SALE"),并说明文字排布位置与字体风格。
  • 激活深度构图逻辑:面对多主体交互场景时,详细阐述主体之间的相对空间方位(如“前景左侧”、“背景正中”),模型将充分发挥思维链规划能力。
  • 保持视觉系列风格:在进行一组概念图创作时,固定 seed 并保持核心风格词一致,仅微调动作或局部元素即可获得连贯的系列视觉。

注意事项

  • 纯文本生成限制:本端点专用于文本生成图像,不接收图片上传;如需使用参考图片请调用 Wan 2.7 Image Edit 端点。
  • 字符长度范围:提示词去除首尾空白后长度需在 1 至 5,000 字符之间。
  • 生成张数范围:单次请求 n 参数支持 1 至 4 张,总扣除积分随张数成线性倍数增长。

相关模型

Wan 2.7 Image Text to Image API 常见问题

Wan 2.7 Image Text to Image API 是什么?

Wan 2.7 Image Text to Image 是阿里通义实验室用于高质量文本生成图像的多模态大模型。它根据纯文本提示词生成细腻生动的 1K 与 2K 图像,支持 Thinking Mode 构图推理、中英双语文字排版渲染与色板精确控色。基于先进的多模态规划器与 DiT 生成架构,它在严格遵循提示词空间逻辑的同时呈现真实光影质感。你可以通过 API 进行程序化调用,也可以在上方体验区直接在线试用。

Wan 2.7 Image Text to Image 一次能生成多张图片吗?

支持单次生成 1 至 4 张独立变体。通过传入 n 参数(取值 1–4)即可批量获取多个构图选项,每张图片均享有相同的分辨率与画质保障,计费按实际输出张数乘以 4.2 积分计算。

Wan 2.7 Image Text to Image 支持画面中直接渲染中文文字吗?

支持。模型具备强大的多语言字形排版能力,在提示词中用双引号注明文字内容并指定位置,即可直接在画面中生成字迹清晰、边缘锐利的中英文字符,非常适合海报与标语制作。

Wan 2.7 Image Text to Image 如何控制生成画面的比例与分辨率?

提供了 6 种预设尺寸(包括 1:1、16:9、9:16、4:3、3:4),同时也支持在 size 字段中传入自定义的正整数像素宽高,涵盖从 1:8 到 8:1 的极端比例需求。

Wan 2.7 Image Text to Image 中的 Thinking Mode 如何发挥作用?

在接收到复杂的场景描述或多主体互动要求时,内置的思维链模块会在图像合成前先行完成空间规划与语义解构,确保画面各元素之间的比例、透视与遮挡关系自然协调。

Wan 2.7 Image Text to Image 是否支持固定随机种子?

支持。通过在请求中传入可选的 seed 整数参数,可以在相同的提示词和尺寸设置下固定初始潜空间噪声,用于对比提示词微调效果或复现特定构图。

任务执行失败时如何结算积分?

系统具备自动退费保障机制。如果任务因格式校验未通过、网络异常或上游生成超时导致失败,系统会自动将预扣除的积分全额返还至账户。