让图像中的角色跟随语音说话
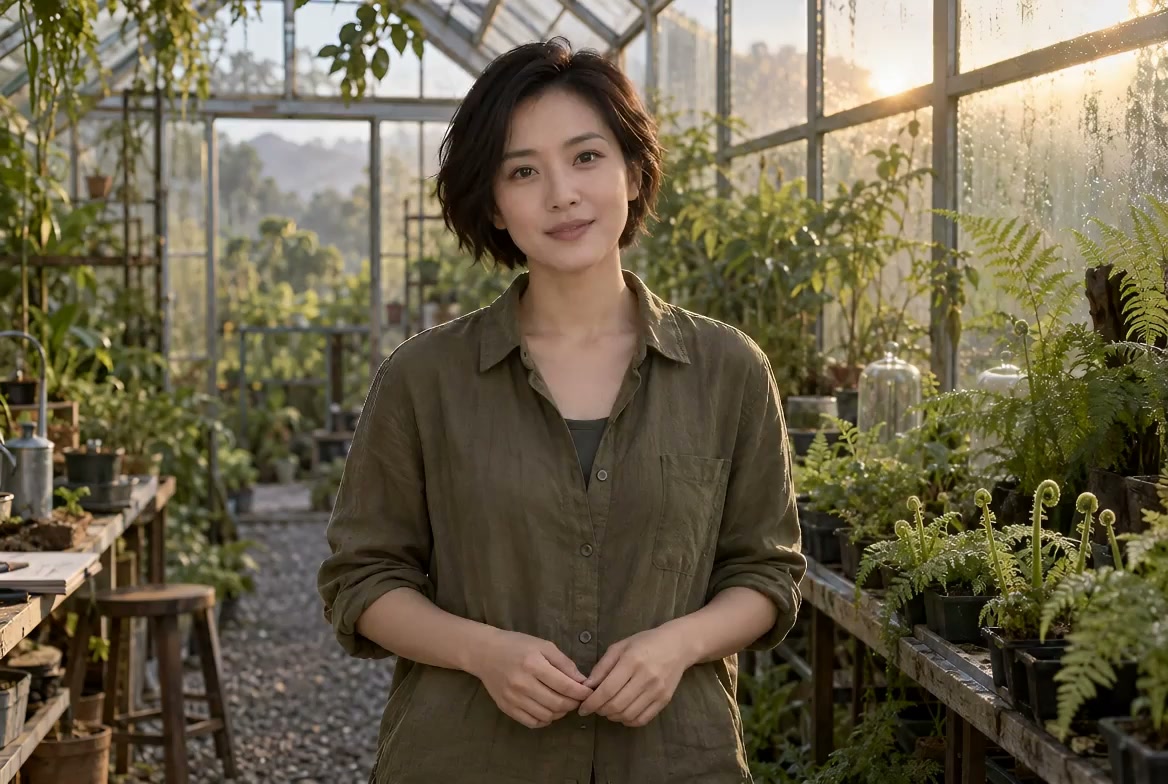
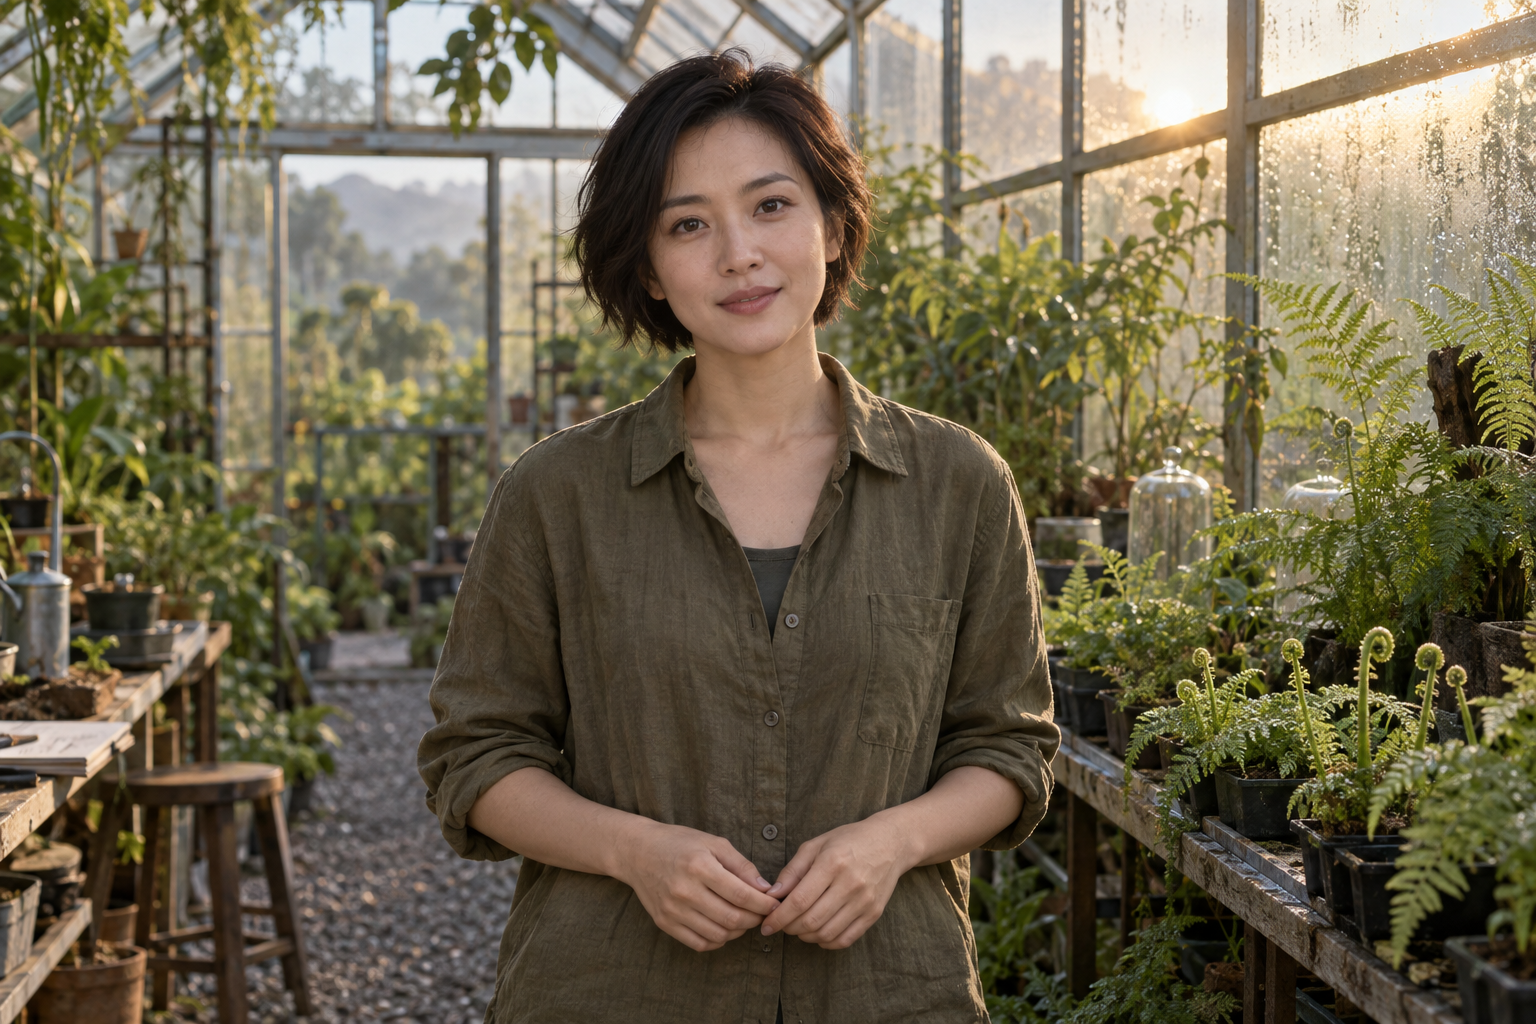
上传一张能够清楚展示角色的图像,并提供语音录音。Kling Avatar 2.0 根据这两项输入生成角色表演,让口部动作跟随音频内容。播放温室案例,可以观察普通话语音、面部动作和植物学家小幅手势之间的关系。
Kling Avatar 2.0 将一张角色图像与一段语音表演生成角色说话视频。图像确定角色外观和场景,音频提供说话内容与时间节奏,可选提示词指导表情和动作。希望以较低的每秒费用完成生成时,可以选择 Standard;重视面部细节和表演表现力时,可以选择 Pro。两个任务均接受 2–60 秒的驱动音频,你可以先准备角色图像、录制或生成语音,再通过相同的输入流程完成角色表演视频。
Kling Avatar 2.0 由快手开发,Vidgo 提供模型接入服务。模型名称与商标归各自所有者所有。准备一张角色图像和一段语音录音,再根据展示目标与预算选择模型版本。Standard 提供较低的每秒费用,Pro 侧重细腻的角色表演。打开对应模型卡片,提交角色图像、语音音频,以及指导面部表情、身体姿态和手势的可选提示词。

Kling Avatar 2.0 Standard turns a single character portrait and driving audio into tightly synchronized talking-avatar video, with natural lip alignment, facial micro-expressions, and prompt-guided performance cues. It preserves facial identity and framing across the full generation cycle while delivering lively, coherent speaking posture and head motion.
Kling Avatar 2.0 Pro turns a character portrait and driving audio into high-fidelity talking-avatar video, with expressive gestures, object-interaction cues, and lifelike micro-movements. It preserves facial identity across longer speaking takes while refining eye motion, neck dynamics, and broadcast-ready presentation quality.
两个版本使用相同的图像与音频输入流程。提交一张图像确定角色外观与构图,再提供一个可公开访问的音频地址,音频时长为 2–60 秒。你还可以通过可选提示词描述表情、动作和场景。下表沿用两个模型已有的介绍,打开对应任务后即可准备素材并查看费用预估。
| 模型与任务 | 输入与工作流 |
|---|---|
| Kling Avatar 2.0 Standard | Kling Avatar 2.0 Standard 将单张角色肖像与驱动音频生成紧密同步的角色说话视频,具备自然的口型对齐、面部微表情,以及通过提示词指导表演的能力。它在整个生成过程中保持面部身份与构图,呈现生动、连贯的说话姿态和头部动作。 |
| Kling Avatar 2.0 Pro | Kling Avatar 2.0 Pro 将角色肖像与驱动音频生成高保真的角色说话视频,具备富有表现力的手势、物体交互指令,以及自然细腻的动作。它在较长的说话镜头中保持面部身份,并进一步细化眼部动作、颈部动态与适用于播出展示的呈现质量。 |
角色图像、语音音频和文字指令分别承担明确的作用。清晰的角色图像提供外观依据,可辨识的录音提供说话内容与时间节奏,具体的提示词描述你希望在生成视频中观察到的表演。
上传一张能够清楚展示角色的图像,并提供语音录音。Kling Avatar 2.0 根据这两项输入生成角色表演,让口部动作跟随音频内容。播放温室案例,可以观察普通话语音、面部动作和植物学家小幅手势之间的关系。
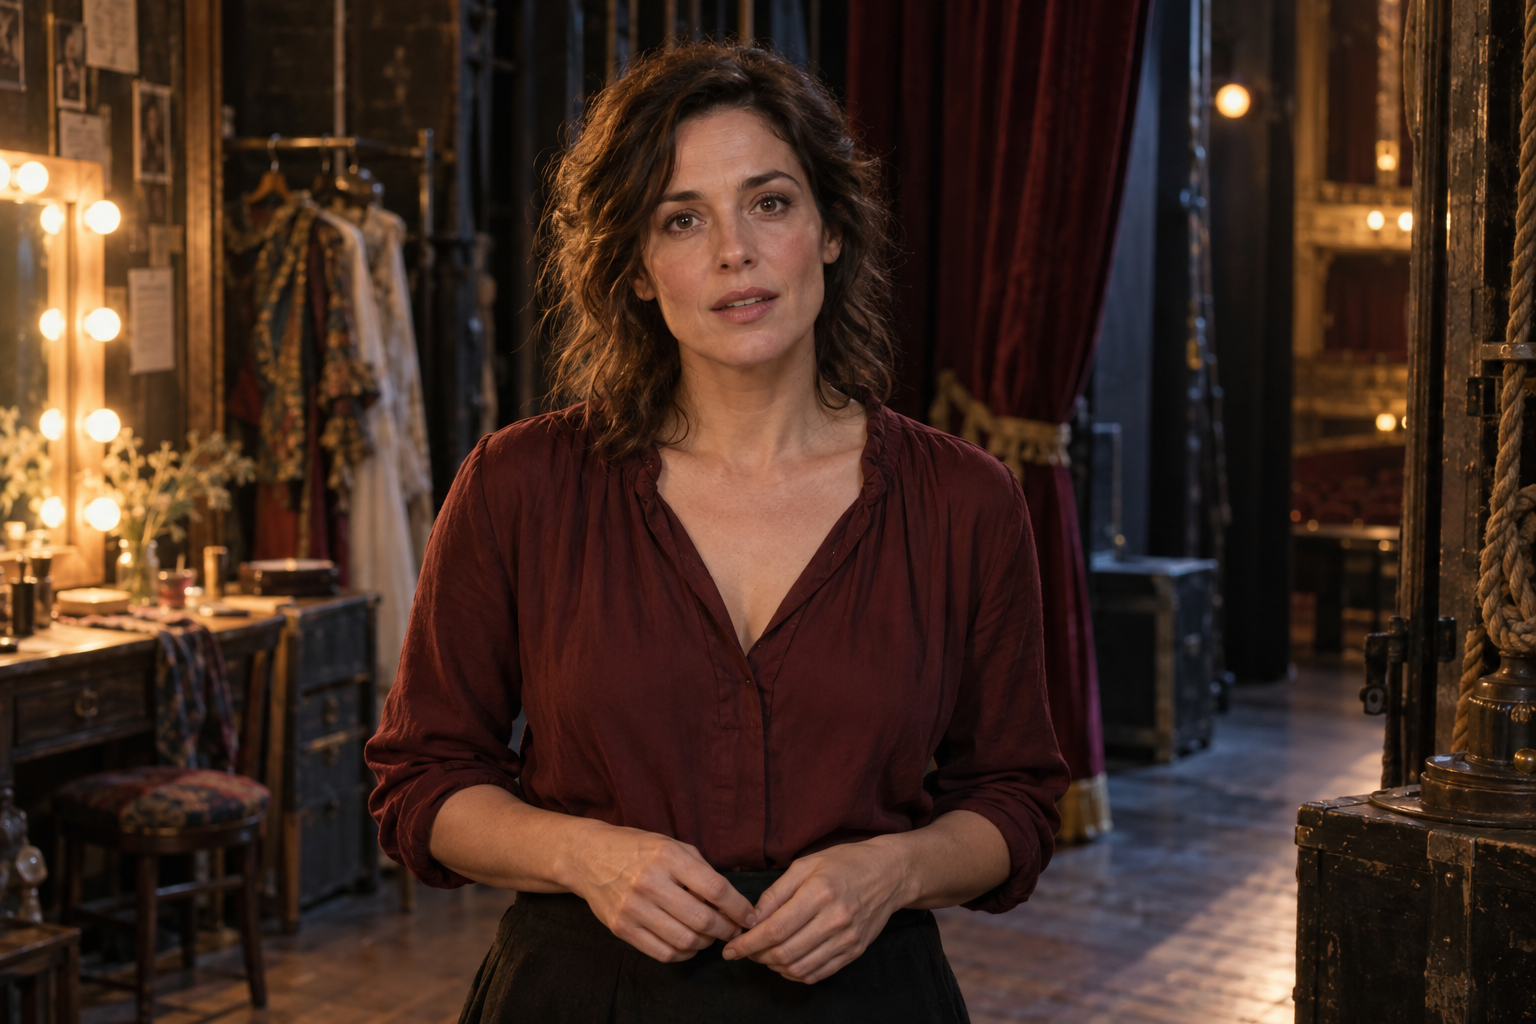
在可选提示词中说明角色最初的情绪、语音停顿后的变化,以及结束时的表情。女演员案例要求角色从脆弱逐渐转为释然,并露出轻微微笑。查看结果时,你可以根据这段明确的表演顺序,观察眼神、肩膀和面部表情的变化。
准备风格化角色图像和符合场景的语音,再描述一个简单的动作与表情。已记录的图书管理员案例使用三维角色、普通话语音,以及在书本上方做出的轻柔安抚手势。你可以查看生成表演如何将原有角色设计延续到说话场景中。
描述一个具有明确目的的动作,并说明角色何时恢复静止。天文学家案例要求角色在英语语音播放期间,向天空做出一次张开手掌的手势,并以轻微微笑结束。你可以用同样清楚的动作描述,指导演示、讲解或角色独白中的表演。
使用时长为 2–60 秒、内容清晰的语音,音频文件应能够公开访问,大小上限为 5 MiB。选择 Standard 或 Pro,并在提交前查看对应单价。服务会检测音频时长并向上取整到完整秒数计费,因此语音表演同时决定镜头的时间节奏与计费时长。
Standard 案例使用温室中的植物学家图像和普通话语音,提示词要求角色向新叶做出小幅手势,随后露出温暖的微笑。Pro 案例使用女演员图像与一段安静的个人倾诉,文字指令描述了从脆弱转为释然的情绪变化。播放输入音频和输出视频,观察口部动作、停顿、表情与手势。两组案例分别保留各自的真实素材和创作要求,展示同一输入流程的两种实际用法。
植物学家用普通话轻柔地说话,朝新叶做出一次小幅张开手掌的手势。停顿之后,她耐心的表情转为温暖的微笑。口型准确同步,自然眨眼,保持角色身份与双手稳定。固定镜头,不切换镜头。
女演员安静地诉说一段个人心事。她最初脆弱的表情在停顿之后逐渐转为释然,并露出轻微而真诚的微笑。轻轻呼出一口气,肩膀放松,双手保持自然。口型精准同步,眼神细腻,保持角色身份稳定。固定镜头,不切换镜头。
先确定角色图像、需要说出的内容和希望呈现的情绪,再录制或生成语音,描述一段简短的表演。生成的视频可以用于需要角色出镜讲述的项目。
准备讲解者的角色图像,以及围绕主题录制的简短旁白。提交音频,并描述专注的表情和一个小幅讲解手势,生成用于课程开场、产品说明或信息演示的角色说话片段。
准备角色图像、录制台词,并确定场景中的情绪变化。描述角色最初的表情、台词中的停顿和最终反应,再将生成视频用于叙事概念或简短角色介绍的表演研究。
选择插画或三维角色图像,以角色的声音录制一段故事,再描述符合情节的轻柔动作与面部表情。通过生成的说话视频,探索故事开场、插画旁白或动画角色场景。
保留选定的角色图像,为每种语言分别准备语音录音,再根据各段说话内容生成对应视频。检查发音节奏、口部动作和表情后,将片段用于多语言演示项目。
录制一段包含明确语速和停顿的台词,再描述角色面部与身体姿态如何随表演变化。生成片段后,观察眼神、口部、肩膀与时间节奏,用结果和创作团队讨论希望采用的情绪方向。
准备可以复用的角色图像,以及录制或生成语音的工作流程。通过 API 提交模型版本、图像、音频和提示词,保存任务 ID 并获取完成的视频,将角色准备、语音制作与视频交付接入应用。
两个版本均根据驱动音频的检测时长计费,时长向上取整到完整秒数,再乘以所选版本当前的每秒单价。动态表格展示起始单价与共同的输入限制;打开任务页面并使用实际音频,即可查看费用预估。音频文件元数据可能包含播放器取整显示之外的小数秒数,计算费用时应以服务检测到的时长为依据。
| 模型 | 厂商 | 版本 | 角色图像数量 | 驱动音频时长 | 起始单价 |
|---|---|---|---|---|---|
| Kling Avatar 2.0 Standard | Kling | Standard | 1 | 2–60 s | $0.035 / 秒 |
| Kling Avatar 2.0 Pro | Kling | Pro | 1 | 2–60 s | $0.07 / 秒 |
准备角色图像和语音,检查生成表演, 再将相同输入用于 API 接入。
打开任务页面,提交一张角色图像,以及可访问的 2–60 秒音频文件,再描述预期的表情或手势。 查看费用预估后提交生成,播放结果并检查口部动作、停顿和角色外观。
Vidgo 将两个 Avatar 版本、在线输入控件、当前价格和任务文档汇集到同一流程中。你可以用角色图像和语音完成测试,检查生成结果,再将选定的模型和素材用于应用接入。
同时查看 Standard 与 Pro,了解已有模型介绍和当前每秒单价,再打开对应模型卡片,测试你的项目重视的表演效果。
在任务页面提交角色图像和音频,补充表情与手势指令。播放生成视频,检查口部动作、语音停顿和角色外观。
提交前查看音频检测时长和所选模型单价,根据应用实际需要处理的语音录音安排测试预算。
查看对应任务文档中的身份验证、模型标识、媒体字段与可选提示词,为每次请求准备可公开访问的音频地址和符合要求的图像来源。
保存返回的任务 ID,并查询状态直至视频完成。需要应用接收完成通知与结果文件信息时,可以提供回调地址。
通过生成记录查看在线测试的历史请求和完成结果。准备下一版场景时,将选定的角色图像、语音与表演指令一并保留。
Kling Avatar 2.0 是快手开发的音频驱动角色视频模型。它将一张角色图像与一段语音录音结合,生成角色说话表演,并接受用于表情、手势和场景指导的可选提示词。Vidgo 提供 Standard 与 Pro 两个任务,两者采用相同的输入流程,并分别使用对应的每秒单价。
阅读 Vidgo API 指南与平台比较文章,了解任务接入、模型选择和使用费用,为角色视频工作流程做好准备。