同时描述可见动作与场景声音
在提示词中写出人物或物体、所在环境、动作过程和镜头运动。开启音频生成时,将声音与画面事件一起描述,例如围巾被风吹起时的布料声,以及站台雨棚上的雨声。本页记录的文字生成案例采用这种结构,创作了一个连续五秒的镜头。
Seedance 2.5 将场景描述、首尾帧,或图像、视频与音频参考转化为 4–30 秒视频。描述人物、动作、镜头运动和声音,再选择 480p、720p 或 1080p 输出。在 Vidgo,你可以分别选择文字生成新场景、通过首尾帧衔接动作,或使用多种参考素材引导视频,并设置是否为成片生成音频。
Seedance 2.5 由 ByteDance Seed 开发。Vidgo 提供模型访问服务。模型名称和商标归其各自所有者所有。从文字构想开始时,选择文生视频;已有起始图片,或需要连接首尾两帧时,选择图生视频;希望同时使用图像、动作视频与声音参考时,选择参考素材生成视频。先明确已有素材和目标画面,再打开对应任务配置成片。

ByteDance Seed's Seedance 2.5 video model with separate text-to-video, start/end-frame image-to-video, and multimodal reference-to-video API workflows at 480p, 720p, or 1080p for 4 to 30 seconds.
ByteDance Seed's Seedance 2.5 video model with separate text-to-video, start/end-frame image-to-video, and multimodal reference-to-video API workflows at 480p, 720p, or 1080p for 4 to 30 seconds.
ByteDance Seed's Seedance 2.5 video model with separate text-to-video, start/end-frame image-to-video, and multimodal reference-to-video API workflows at 480p, 720p, or 1080p for 4 to 30 seconds.
文生视频使用完整的场景描述生成画面;图生视频通过一张或两张按顺序上传的图片确定起始画面与可选的结束画面;参考素材生成视频则让图像、动作视频和声音分别承担人物外观、动作过程与听觉氛围的引导。每种任务保留独立的输入字段和输出设置,便于根据创作目标组织素材。
| 模型与任务 | 输入与工作流 |
|---|---|
| Seedance 2.5 Text-to-Video | ByteDance Seed 的 Seedance 2.5 视频模型,提供独立的文生视频、首尾帧图生视频和多模态参考素材生成视频工作流,支持 480p、720p 或 1080p 分辨率,以及 4–30 秒时长。 |
| Seedance 2.5 Image-to-Video | ByteDance Seed 的 Seedance 2.5 视频模型,提供独立的文生视频、首尾帧图生视频和多模态参考素材生成视频工作流,支持 480p、720p 或 1080p 分辨率,以及 4–30 秒时长。 |
| Seedance 2.5 Reference-to-Video | ByteDance Seed 的 Seedance 2.5 视频模型,提供独立的文生视频、首尾帧图生视频和多模态参考素材生成视频工作流,支持 480p、720p 或 1080p 分辨率,以及 4–30 秒时长。 |
用文字说明动作,用首尾帧确定视觉起点和终点,或组合参考素材来引导人物、运动与声音。为每份素材明确分工,再通过时长、分辨率和音频设置定义成片要求,让生成请求对应一个具体镜头。
在提示词中写出人物或物体、所在环境、动作过程和镜头运动。开启音频生成时,将声音与画面事件一起描述,例如围巾被风吹起时的布料声,以及站台雨棚上的雨声。本页记录的文字生成案例采用这种结构,创作了一个连续五秒的镜头。
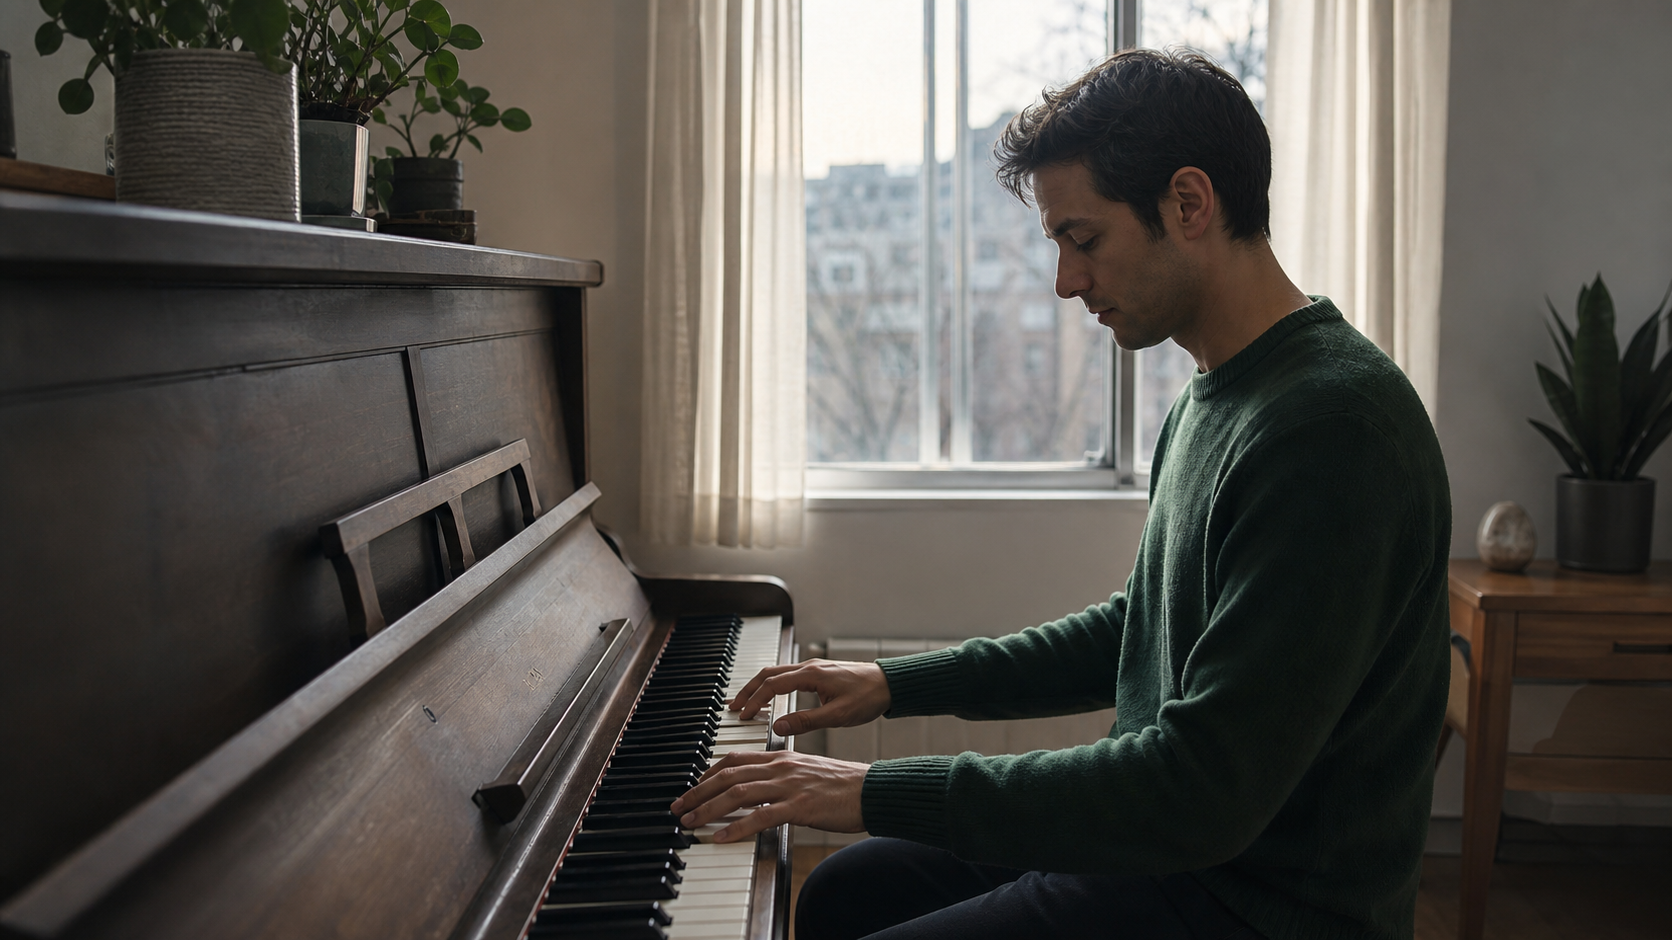
上传起始图片;需要指定最后的姿势或构图时,再上传一张结束图片。说明两帧之间的动作,同时写清需要保留的人物、服装、房间与光照。这种工作流为分镜转场或人物手势提供明确的视觉起点和终点。
用图像提供人物外观,用视频提供动作过程或镜头运动,再用音频提供节奏或氛围。在提示词中逐一说明这些作用,并描述新场景的位置和事件。参考任务先提供至少一张图像或一段视频,再添加音频,为同一个镜头补充声音引导。
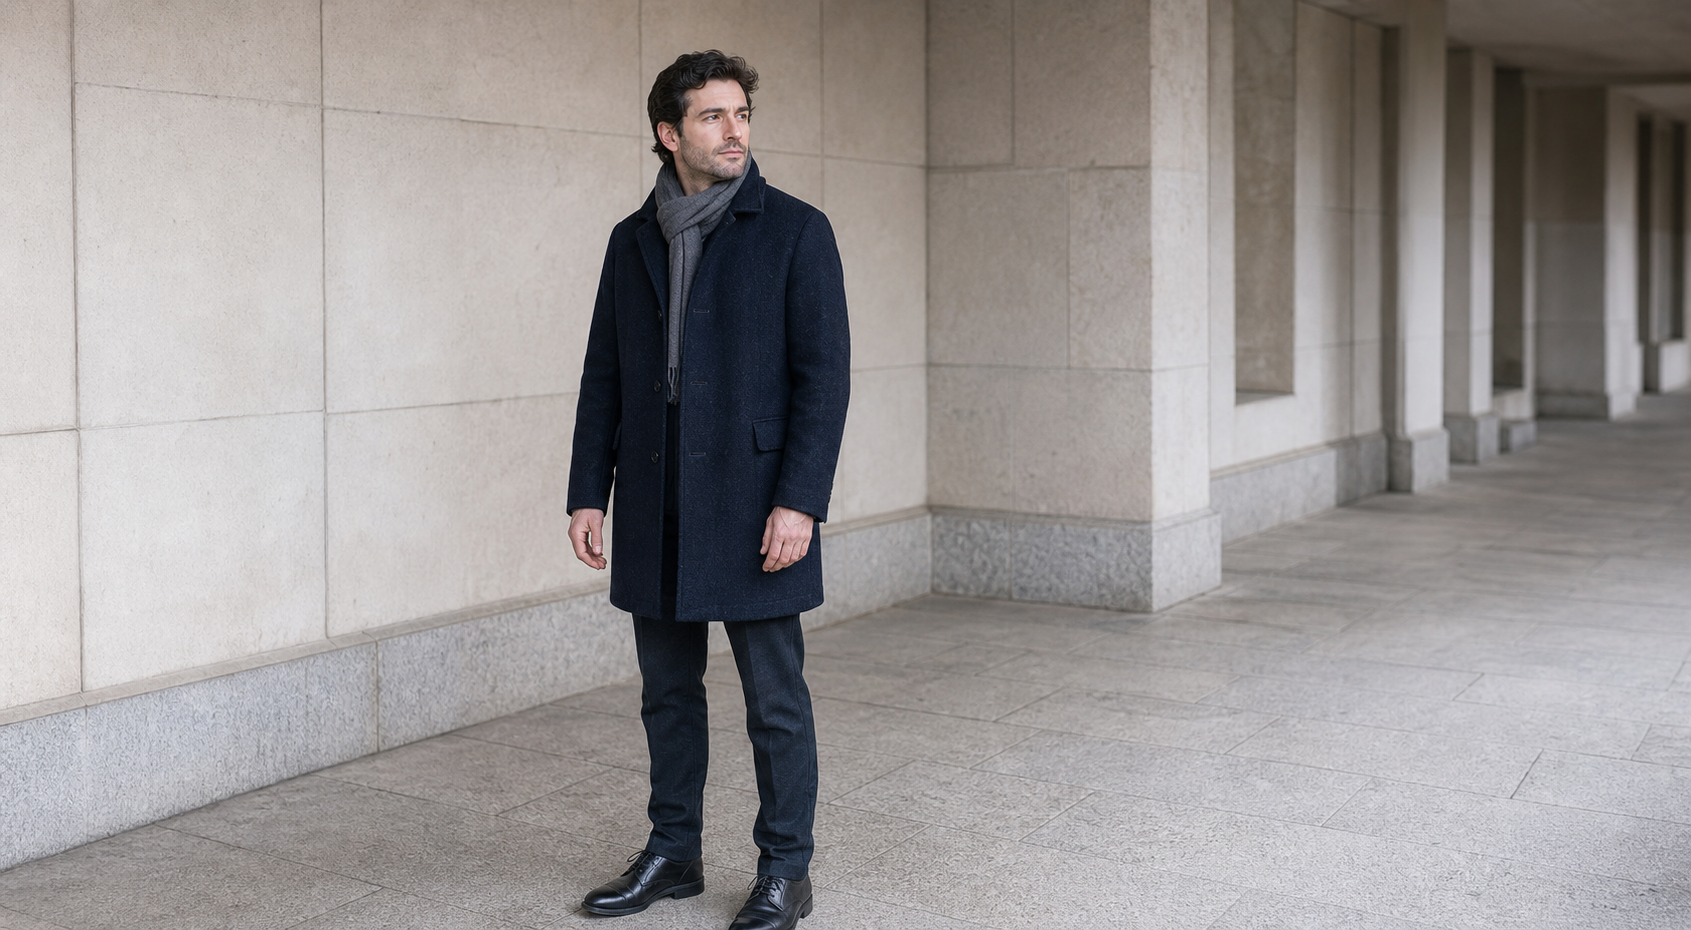
将动作拆成连贯的短序列,并指定清楚的镜头运动,例如弹奏三个音符、抬起双手、转向窗户,同时让镜头缓慢推进。钢琴师案例将这些要求与首尾帧一起提交,你可以在生成视频中观察手部运动、身体转动和最后姿势。
将视频时长设置为 4–30 秒的整数,并选择 480p、720p 或 1080p。文字与参考任务提供适用于不同展示位置的画幅选项,图生视频根据输入图片自动确定画幅。选择是否生成音频,再到任务页核对当前设置和参考素材对应的调用费用。
第一组记录使用钢琴师的两张图片,生成弹奏、抬手并转向窗户的短镜头。第二组记录结合男性人物外观、转身接物的动作视频和雨声音频,创作夜晚渡轮通道里的新场景。阅读完整提示词,并对照每份输入素材与生成视频,观察请求如何分别规定人物身份、动作、镜头方向和声音。
严格从图片 1 开始,并以图片 2 结束。在一个连续五秒的镜头中,钢琴师轻轻弹奏三个音符,让双手从琴键上抬起几厘米,然后将头部和肩膀转向窗户,同时微风吹动窗帘。只使用一次缓慢、稳定的镜头推进。全程保留相同的面孔、头发、绿色毛衣、坐姿、钢琴、房间布局、镜头轴线和晨间光线。保持双手符合自然人体结构,并平稳进入最后姿势,避免形变。同步音频:三个轻柔的钢琴音符、轻微的窗帘窸窣声,以及安静的室内环境声。不要切换镜头,不要增加其他人物,不要对话、可读文字、标志、产品植入、广告或水印。
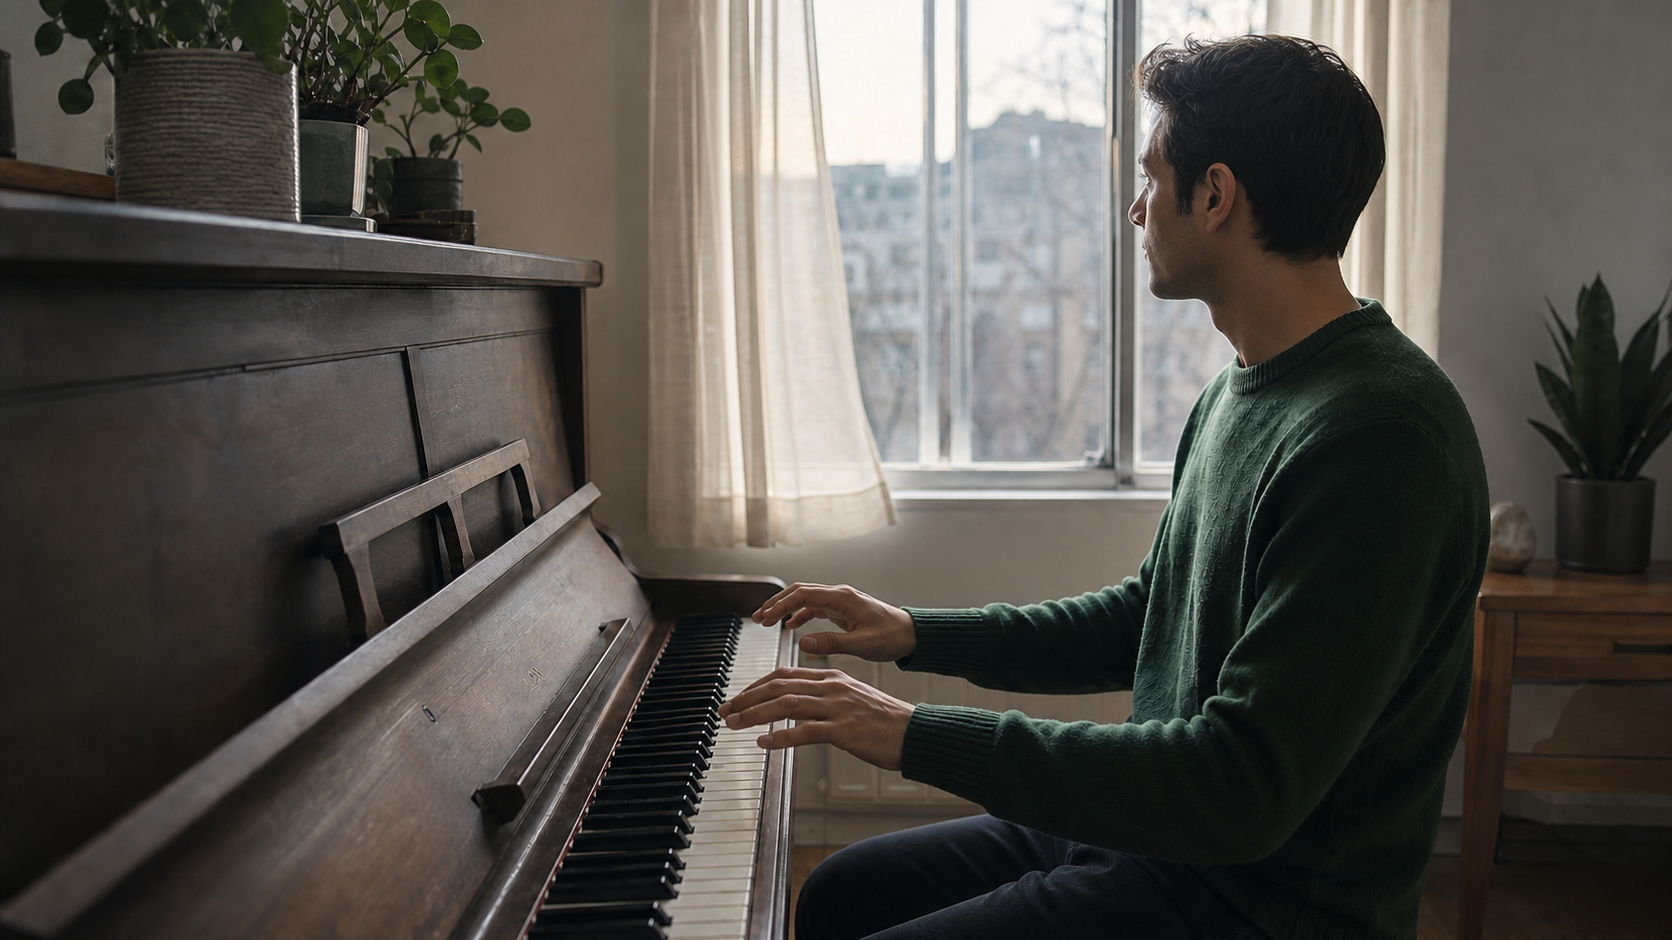
参考图像 1 仅用于确定虚构男性的面孔、短而略卷的深色头发、深蓝色羊毛外套、灰色围巾和身体比例。参考视频 1 仅用于确定一次转身并接住物体的动作、自然重心变化、衣料动作的时间关系,以及缓慢的腰部高度镜头运动;不要复制其中的女性、她的服装或火车站台。参考音频 1 仅用于确定雨势强度和动作时间关系。在夜晚安静的有顶渡轮通道里,创作一个连续五秒的镜头。男性独自站着,右手拿着一个素色奶油白信封。一阵短暂的风让信封脱手;他转身一次,将信封接回胸前,然后静止。全程保留参考图中人物的身份和服装。同步音频:屋顶上的轻柔雨声、一次纸张飘动声,以及远处的水声。不要切换镜头,不要增加其他人物,不要对话,不要在信封上写字,不要出现可读文字、标志、产品、广告或水印。
先准备场景描述、分镜图片或选定的参考素材,再选择适合的任务。明确人物、动作、镜头和声音各自的作用,并根据后续使用位置设置视频时长与分辨率,让生成结果服务于具体作品。
准备人物或物体、环境、动作与镜头运动的描述,使用文生视频创作短片段。开启音频生成时,补充场景中的环境声与动作声。将结果作为场景研究、分镜构想或短篇叙事概念,确认方向后再规划下一个镜头。
准备能够确定人物、服装、构图和光照的图片,描述手势、表情或身体动作,再使用图生视频生成片段。生成结果可以帮助你探索人物出场、动态肖像,或在已经确定的视觉方向中设计一段动作。
准备包含目标人物与场景的起始帧和结束帧,按顺序上传,说明中间的动作过程并选择时长。规划连续镜头、演示转场或动态视觉故事时,检查人物与镜头如何从第一种状态过渡到第二种状态。
准备人物参考图和展示目标运动的视频,在参考任务中说明哪份素材提供人物身份,哪份素材提供动作,再描述新的位置与事件。将生成结果用于研究不同人物或不同场景中的动作表现。
将视觉参考与提供节奏、时间关系或氛围的音频组合使用。说明声音与动作之间的关系,并描述成片需要生成的声音。生成结果可以用于探索短篇视听场景、音乐片段,或由听觉氛围推动的叙事构想。
根据横屏演示或竖屏视频项目选择时长、分辨率与任务支持的画幅,通过选定工作流生成片段。评审动作、构图、声音和最后姿势,保存生成结果及提示词,让团队围绕同一创作方向讨论。
文生视频、图生视频,以及使用图像与可选音频参考的任务,按输出时长和分辨率计费。包含参考视频时,使用对应费率,并将生成视频时长与每段参考视频的计费时长合并计算。表格展示各任务的最低可用费率;提交前,请在任务页选择实际设置并添加参考素材,查看完整的费用预估。
| 模型 | 厂商 | 工作流 | 图像输入上限 | 最高输出分辨率 | 起始费率 |
|---|---|---|---|---|---|
| Seedance 2.5 Text-to-Video | ByteDance | 文生视频 | 不适用 | 1080p | $0.14 / 输出秒 |
| Seedance 2.5 Image-to-Video | ByteDance | 图生视频 | 2 | 1080p | $0.14 / 输出秒 |
| Seedance 2.5 Reference-to-Video | ByteDance | 参考素材生成视频 | 30 | 1080p | $0.085 / 计费秒 |
使用自己的素材在线验证镜头, 再将同一提示词与设置接入应用。
输入提示词,上传任务需要的素材,并设置时长、分辨率和是否生成音频。图生视频中,将起始帧放在第一位,可选的结束帧放在第二位。 检查生成视频的动作、镜头运动、人物外观和声音,再围绕目标结果完善指令。
Vidgo 将工作流选择、在线体验、费用查询和任务文档连接起来。对照真实输入与视频结果,确定场景需要的设置,再使用对应任务准备 API 接入。
集中查看三种视频任务,选择文字描述、首尾帧或多模态参考作为生成依据。每张模型卡片打开对应任务,并提供该任务实际使用的输入控件。
播放本页记录的视频,并检查输入的首尾帧、人物参考、动作视频和音频。根据观察结果,把自己的动作、外观和时间关系写得更加明确。
在任务页选择时长与分辨率。添加参考视频时,同时检查参考素材计入费用的方式,让预估对应实际提交的素材。
打开所选任务的文档,查阅身份验证、允许的字段与请求示例。按照在线验证的工作流准备图像、视频和音频地址。
保存返回的任务标识,查询处理状态,并获取完成后的视频地址。应用需要收到结果通知时,在请求中添加回调地址。
通过生成记录查看在线测试使用的素材、提示词与结果文件。规划下一轮创作修改时,保留已选视频及其设置作为讨论依据。
Seedance 2.5 是 ByteDance Seed 的视频生成模型,能够根据文字场景描述、给定的首尾帧或多模态参考素材生成短视频。Vidgo 提供文生视频、图生视频和参考素材生成视频三个独立任务,支持 4–30 秒时长,480p、720p 或 1080p 分辨率,以及可选的音频生成设置。根据已有素材和希望创作的场景选择对应工作流。
阅读 Vidgo 的模型接入指南与平台比较文章,了解 API 使用方式、模型选择和费用信息,为创作与开发准备参考。