在完整场景中写清对白
描述说话者、位置、周围活动与准确台词。洗衣店记录要求一位女性注意到红袜子并说出 There you are,同时呈现机器低鸣,可以对照请求检查可见发言、烘干机场景与时间安排。
Wan 2.5 可以根据文字场景或一张首帧创建 5 秒或 10 秒视频,提供同步音频与最高 1080p 输出。描述主体、可见动作、镜头与声音,还可以通过可选音频文件地址提供视频需要的录音。文字生成通过 aspect_ratio 选择横向或竖向像素尺寸,图像生成使用一张 image_urls 来源与 480p、720p 或 1080p 分辨率。根据场景或首帧选择工作流,生成前查看完整时长价格。
Wan 2.5 由 Alibaba 开发,Vidgo 提供模型调用服务。模型名称与商标归各自所有者所有。需要通过提示词确定完整人物、环境和动作时,使用文生视频;准备好的单张图像提供需要保留的面部、材料、物体或构图时,使用图生视频。两种工作流都需要说明运动与可听事件的时间安排,选择 5 秒或 10 秒,并查看目标画布对应的输出档位。
两种任务都使用 prompt 与 duration,并提供可选 audio、negative_prompt 和 seed。文字生成的 aspect_ratio 使用宽*高像素值,例如 1280*720;图像生成提供准确一项公开 image_urls,并通过 resolution 设置分辨率。提供录音时使用音频文件地址,同时在提示词中写清可见动作与声音。
| 模型 / 任务 | 输入与工作流 |
|---|---|
| Wan 2.5 Text to Video | 根据文字或一张图像生成 5 秒或 10 秒视频,提供同步音频与最高 1080p 输出。 |
| Wan 2.5 Image to Video | 根据文字或一张图像生成 5 秒或 10 秒视频,提供同步音频与最高 1080p 输出。 |
已有记录展示洗衣店台词、电话接线员、浣熊触碰金属碗、食蚁兽喷嚏与橙子滚下台阶。各项请求明确可见事件及其伴随声音,可以结合实际片段检查时间安排、身份特征、接触与目标音频。
描述说话者、位置、周围活动与准确台词。洗衣店记录要求一位女性注意到红袜子并说出 There you are,同时呈现机器低鸣,可以对照请求检查可见发言、烘干机场景与时间安排。
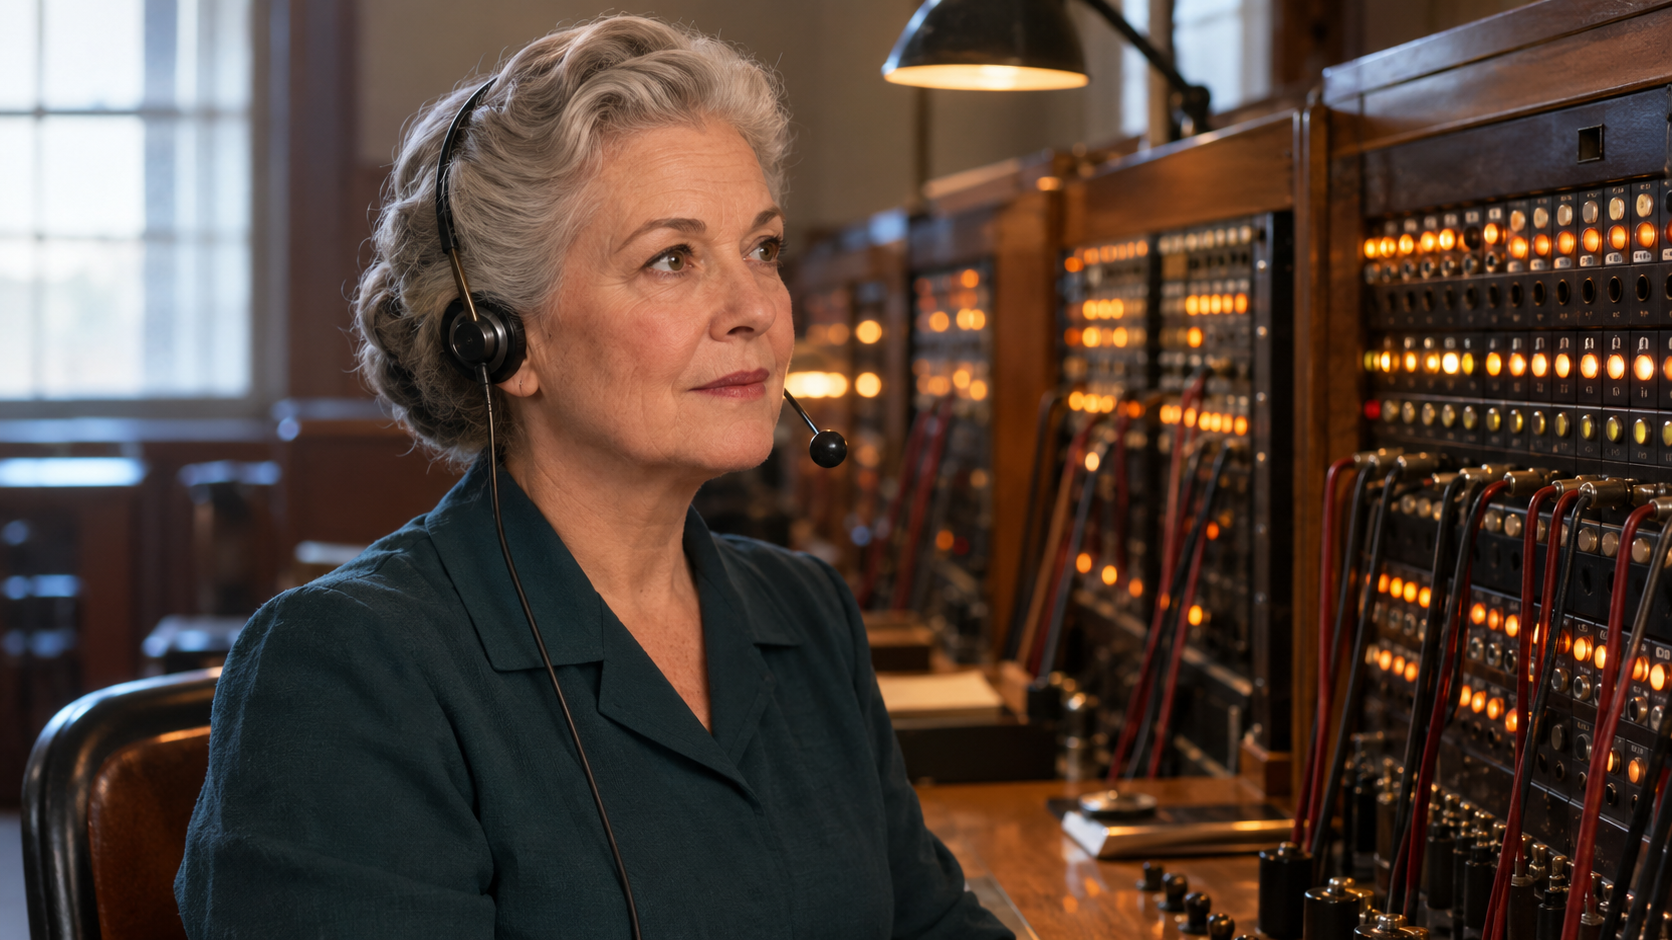
提供一张首帧,明确需要保留的面部、服装与环境。电话记录要求来电小灯亮起、轻微侧头与 One moment, please,可以结合来源检查外观、口型及要求的铃声和室内低鸣。
描述爪子与碗的接触位置,以及碗随后的运动。浣熊记录要求一次轻推、半圈晃动与金属轻响,可以检查实际片段中的接触、形状与声音时间安排。
明确形态、生境与短暂运动。食蚁兽记录要求在白蚁丘旁打喷嚏,呈现少量尘土、干燥风声和远处昆虫,可以结合要求的声音检查口鼻、身体与可见事件。
写清物体路径、碰撞次数与镜头反应。橙子记录要求一个果实从袋中滚出并落下两级台阶,伴随纸张摩擦与两次低沉碰撞,可以检查重力、接触与时间安排,用于小型叙事动作。
文字案例要求一位女性通过关闭的烘干机窗注意到红袜子,并说出 There you are;图像案例使用电话接线员肖像,要求小型指示灯变化、轻微侧头与英文台词 One moment, please。阅读完整提示词,结合准备好的画面与对应结果,检查目标运动和音频。
黎明时安静的自助洗衣店内,一个连续五秒的真实电影镜头。恰好一位深色短卷发、穿黄色雨衣的年轻成年女性。紧凑胸部以上构图:她的面部位于左半部分,右半部分是恰好一个关闭的圆形烘干机窗口。烘干机门全程牢牢关闭并锁住,玻璃后方的一只小红袜子随滚筒中的白色衣物缓慢转动。她已经站定,向右看着袜子,然后微笑并以英语轻声说出:“There you are.” 她的嘴部保持清楚可见。固定镜头,不要镜头运动或切镜。哑光白色机器外壳,不要镜子、人物反射或额外人物。冷色荧光照明。音频:一位自然女性声音,仅说出引号中的台词,口型同步,并伴随轻柔机器低鸣。不要音乐、说明文字、文字、标志或水印。
保留参考图像:相同的银发年长女性接线员、耳机、服装、交换台与坐姿。面部清楚可见的中近景。她后方的小型来电指示灯亮起;她倾听,轻微侧头,并以英语清楚说出:“One moment, please.” 她的嘴唇准确跟随台词,最后露出轻微安抚微笑。镜头保持稳定,仅呈现克制呼吸与细微灯光变化。音频:安静来电铃声,随后是平静自然的人声与低沉电气室环境声,不要音乐。连续五秒镜头,不要切镜、字幕、说明文字、可见书写、标志、广告或水印。
准备场景描述或一张首帧,明确运动与可听事件,并选择 5 秒或 10 秒。检查后的视频可以用于对白分镜、肖像动画、物体互动研究、野生动物片刻与小型叙事动作。根据实际结果检查发言、身份特征和物理时间安排,再开发下一次变化。
写清说话者、准确台词、周围活动与环境声,生成场景并检查可见发言和时间安排,用于电影构思或叙事分镜。
提供清楚呈现面部、服装与周围环境的画面,描述受控动作和台词,再结合来源检查身份特征、表情与音频,用于角色研究。
提供或描述物体,明确接触位置及其声音,再检查生成的运动、碰撞与余音,用于声音设计或动画构思。
描述一只动物、生境与带环境声的短暂自然动作,再检查形态、运动和环境,用于纪实风格场景提案。
写清动作顺序,例如物体滚动并发生两次碰撞,再生成片段并检查物理时间安排,用于分镜或视觉说明。
准备对应场景或首帧,并提供计划使用的音频文件地址,描述相应可见动作,再检查生成视频与录音的关系,用于对白或声音引导构思。
Wan 2.5 按单个视频设置 5 秒或 10 秒,以及 480p、720p、1080p 价格档位。文字生成通过像素尺寸确定分辨率档位,图像生成直接选择 resolution。下方动态表格展示各任务当前起价与单位,提交前请在任务页设置实际尺寸或分辨率和时长,查看完整视频估算。
| 模型 | 厂商 | 任务类型 | 输入素材 | 输出规格 | 起价 |
|---|---|---|---|---|---|
| Wan 2.5 Text to Video | Alibaba | 文生视频 | 文字提示词,可选音频 | 1080p | $0.15 / 个视频 |
| Wan 2.5 Image to Video | Alibaba | 图生视频 | 1 张首帧,可选音频 | 1080p | $0.15 / 个视频 |
先在线测试创作方案, 再将确认后的请求接入应用。
选择对应任务,查看参数与费用,并将在线测试中的素材和设置用于经过身份验证的 API 请求。
根据文字创建场景时选择文生视频,为一张首帧创建动画时选择图生视频,并设置 5 秒或 10 秒。文字任务选择支持的横向/竖向像素值,图像任务选择 480p、720p 或 1080p。描述声音,并按需要提供音频文件地址。
填写动作、准确对白与可听事件,使用图像任务时增加一张原图。选择时长和任务对应的尺寸或分辨率,需要录音时增加可选来源,再查看估算。对照要求检查输出中的身份特征、运动、接触、可见发言和音频时间安排。
根据所选 5 秒或 10 秒档位,以及文字画布确定或图像动画选择的分辨率,比较完整视频金额,再结合计划测试次数安排工作流预算。
结合实际提示词或原始请求参数、全部来源图像或视频及生成片段查看案例,了解如何说明输入作用、动作变化过程,以及自己请求中需要保留的细节。
保存 API 返回的任务 ID,用于查询生成状态并获取完成文件的地址。通过在线生成记录回看先前结果与测试过的创作方向。
通过各任务提供的文档查看准确的模型标识、支持的输入、身份验证方法与响应格式。接入已经在线测试过的任务,使请求中的素材与设置保持一致。
Wan 2.5 是 Vidgo 提供的 Alibaba 视频模型,包含文字与单图生成,支持 480p–1080p 的 5/10 秒片段、同步音频与可选音频文件输入。文字生成使用明确像素尺寸,图像生成使用一张画面与分辨率设置。
阅读模型介绍、API 接入指南与平台比较,了解项目所需的输入素材准备、请求接入方法与费用规划。