通过文字场景构建摄影画面
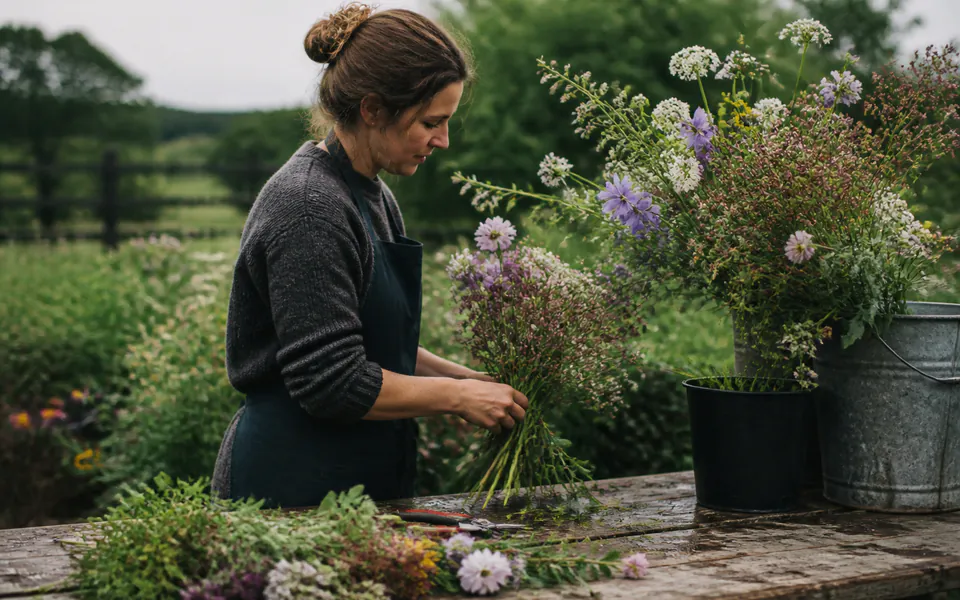
在同一段要求中说明人物、活动、地点、光线与摄影处理。市集示例要求女孩饮用粉色珍珠奶茶,并描述阳光下的帐篷、虚化人群与胶片颗粒。可以对照这些指令检查场景安排与摄影效果。
使用 GPT-4o Image,将文字创作要求转化为摄影画面、插画概念或带有文字的海报,也可以提供参考图并说明需要修改的内容。现有任务页集中提供生成与编辑功能:使用 gpt-4o-image 进行文字生成,使用 gpt-4o-image-edit 结合参考图和可选蒙版完成编辑。输出可以选择正方形、竖向或横向比例;文字生成可以请求一至四张图像,编辑请求返回一张图像。
GPT-4o Image 由 OpenAI 开发,Vidgo 提供模型调用服务。模型名称与商标归各自所有者所有。打开 GPT-4o Image 任务,选择生成或编辑模式。构图仍处于文字构思阶段时,可以从文字开始生成;已有主体、环境或设计素材时,可以将现有图像作为视觉起点。
进行文字生成时,说明主体、构图、材料、光线以及需要出现在画面中的准确文字。进行图像编辑时,上传参考图,描述修改要求并明确需要保留的细节;修改需要限定在选定区域时,可以添加蒙版。两种模式的提示词上限均为 1,000 个字符,画面比例支持 1:1、2:3 与 3:2。当前在线编辑表单接收一张参考图。
| 模型 / 任务 | 输入与工作流 |
|---|---|
| GPT-4o Image | OpenAI 原生多模态图像生成模型,具备出色的文字呈现、精准的提示词遵循与对话式编辑能力。 |
PoYo 已公开示例包括农夫市集照片、文字海报以及为猫添加侦探配饰的编辑结果,每组保留原始提示词与媒体配对。可以结合这些示例观察主体描述、准确文字和基于参考图的指令如何参与生成;这些独立演示分别展示不同创作要求。
在同一段要求中说明人物、活动、地点、光线与摄影处理。市集示例要求女孩饮用粉色珍珠奶茶,并描述阳光下的帐篷、虚化人群与胶片颗粒。可以对照这些指令检查场景安排与摄影效果。

用引号标明需要出现的准确文字,并为每一段文字指定位置。海报提示词将标题放在顶部、短句放在右下方、说明放在底部,同时要求雕塑从线框草图过渡为写实画面。可以同时检查文字内容与位置。

在编辑任务中上传清楚的来源图像,并说明需要添加或修改的内容。猫的示例以提供的猫咪照片为起点,为模型提供明确主体,再在该主体上放置要求中的配饰。
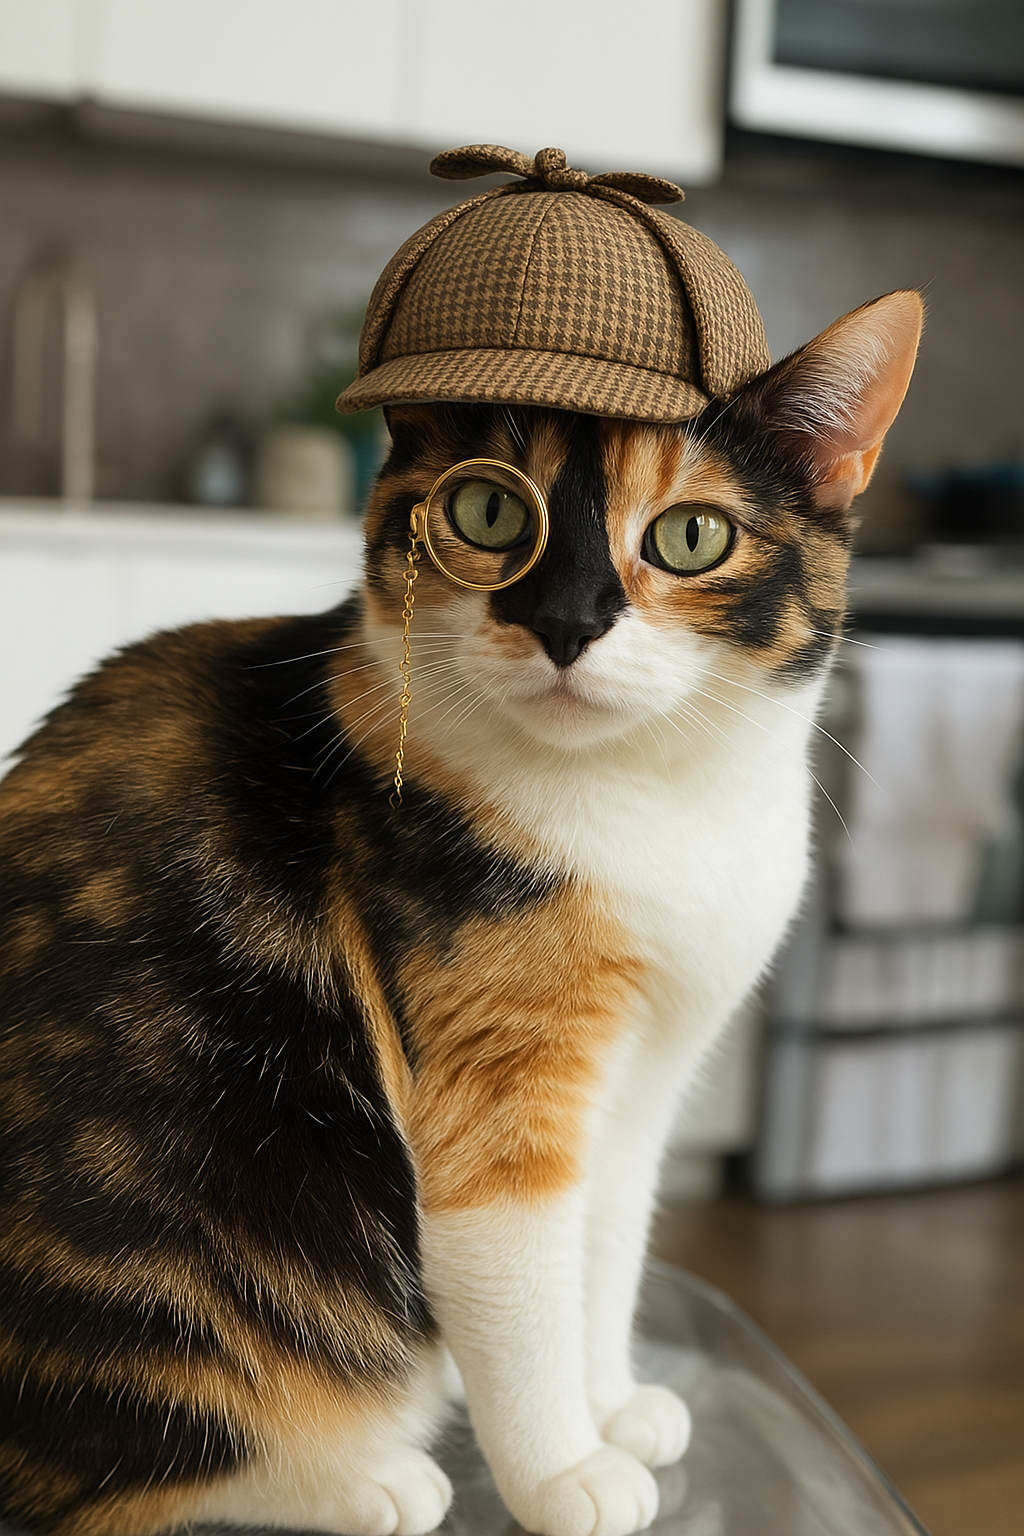
公开编辑指令要求添加侦探帽与单片眼镜,可以对照来源图和结果检查这些新增配饰及周围主体。进行自己的局部编辑时,可以在 gpt-4o-image-edit 请求中通过可选 mask_url 指定区域,并在提示词中说明目标修改。
{
  "size": "3:2",
  "n": 1
}正方形素材可以选择 1:1,竖向作品可以选择 2:3,横向构图可以选择 3:2。希望探索多个生成结果时,在文字生成请求中将 n 设为一至四。编辑请求使用 n: 1,每次请求返回并计费一张图像。
这两组 PoYo 公开体验示例保留完整提示词与原始 CDN 结果。海报请求指定三处文字位置,以及从线框到摄影画面的雕塑过渡;编辑请求以展示的猫咪图像为来源,要求添加帽子与单片眼镜。可以分别对照各自提示词检查结果,并将编辑结果与来源图像进行比较。
创建一张竖向海报,在顶部写上“ChatGPT image generation”,在右下方写上“Form follows function”。背景放置一张造型简洁、现代的雕塑照片,让它从左侧的线框草图逐渐过渡到右侧的完全写实版本。在最底部,用中小字号写上“This entire poster was generated by ChatGPT image generation.”。
给这只猫戴上一顶侦探帽和一副单片眼镜。
准备完整创作要求或已有视觉素材,再根据工作目标选择生成或编辑。在将图像用于演示、内容页面或设计草稿之前,检查文字准确性、主体外观、画面比例与要求中的修改。
准备主体、动作、地点与光线要求,生成场景以探索目标视觉叙事。结果可以用于编辑情绪板,也可以为后续摄影拍摄提供参考。
准备准确标题、辅助文字与预期位置,再描述背景画面和视觉层次。检查生成文字与构图,将作品用于活动海报、宣传草案或演示封面。
上传已有角色或动物图像,描述需要添加的配饰、服装细节或道具。开发插画概念与角色变体时,可以将编辑主体与来源图进行比较。
准备来源图像与目标区域蒙版,说明该区域需要呈现的新内容或外观。检查修改区域与周围画面的衔接,再将结果用于设计迭代。
说明构图中的主体与所需空间,再选择 1:1 或 2:3。检查裁切与文字位置,将图像用于社交内容、文章插图或竖向宣传草稿。
编写清楚的文字生成要求,并选择一至四张输出。对照返回图像的构图与主体处理方式,选定方向后继续进行下一轮创作迭代。
下表读取当前目录中的任务费率。文字生成通过 n 请求并计费一至四张图像,因此请求数量会影响总费用。编辑模型每次请求返回并计费一张图像,编辑时使用 n: 1。当前接口提供画面比例设置,可以根据下方动态起价与所选任务的费用估算,为完整请求安排预算。
| 模型 | 厂商 | 任务类型 | 输入素材 | 输出规格 | 起价 |
|---|---|---|---|---|---|
| GPT-4o Image | OpenAI | 图像生成 / 编辑 | 文字提示词;在线编辑使用一张参考图与可选蒙版 | 1:1 / 2:3 / 3:2 | $0.02 / 次生成 |
先在线测试完整创作要求, 再将确认后的请求接入应用。
填写完整创作要求,选择模式与画面比例,并查看生成费用估算。在线编辑时,上传一张 10 MiB 以内的 JPEG、PNG 或 WebP 参考图,需要限定区域时再添加蒙版。生成结果后,检查准确文字、主体细节与要求中的修改。
通过现有任务页、当前价格信息、任务文档与生成记录,将创作测试衔接到 API 工作流。
打开 GPT-4o Image 任务,为全新构图选择文字生成,为现有图像选择编辑。准备不超过 1,000 个字符的提示词,选择 1:1、2:3 或 3:2;提供参考图或蒙版时,使用编辑模式。
填写完整创作要求,选择模式与画面比例,并查看生成费用估算。在线编辑时,上传一张 10 MiB 以内的 JPEG、PNG 或 WebP 参考图,需要限定区域时再添加蒙版。生成结果后,检查准确文字、主体细节与要求中的修改。
下表读取当前目录中的任务费率。文字生成通过 n 请求并计费一至四张图像,因此请求数量会影响总费用。编辑模型每次请求返回并计费一张图像,编辑时使用 n: 1。当前接口提供画面比例设置,可以根据下方动态起价与所选任务的费用估算,为完整请求安排预算。
打开任务文档,查看身份验证方式、模型标识、必填输入、支持的输出设置与响应字段。使用参考图时,准备可访问并可直接下载的 HTTP(S) 图像地址,再将测试确认后的提示词与参数填入请求。
使用对应的模型标识与 input 对象发送经过身份验证的请求。保存响应返回的任务 ID,供应用跟踪本次生成;应用具备接收任务通知的能力时,可以在请求中填写回调地址。
使用任务 ID 查询状态,或处理已经配置的回调通知。任务完成后,读取生成文件的地址,保存项目所需的结果,并对照原始创作要求检查内容。调整下一次请求时,可以从账户生成记录中回看在线测试结果。
GPT-4o Image 是 OpenAI 的图像生成与编辑系列,通过 Vidgo 现有任务页使用。文字生成使用 gpt-4o-image,结合参考图与可选蒙版的编辑使用 gpt-4o-image-edit。任务页提供在线测试、API 文档与生成文件获取入口。
阅读模型介绍、API 指南与平台比较,了解创作输入、接入方式与生成费用。