用文字构建音视频场景
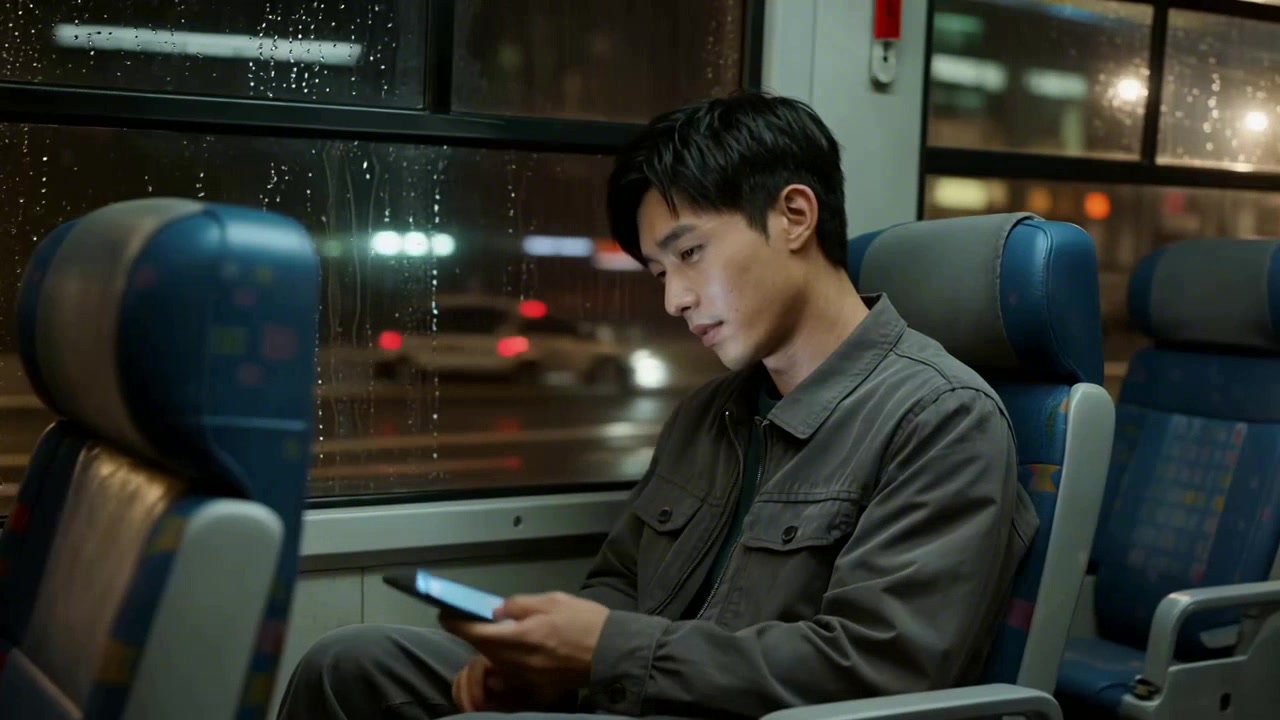
同时描述场景、主体、动作与声音,并开启生成音频。雨夜巴士案例从文字构思出发,要求生成一段连续镜头;构思叙事片段时,可以结合结果中的动作、对白与环境氛围进行检查。
Seedance 1.5 Pro 根据文字描述或一至两张输入图像生成 4、8 或 12 秒视频,并可同时生成音频。你可以描述主体动作、镜头方向、对白与环境声音,再为使用场景选择 480p、720p 或 1080p 分辨率和画面比例。文生视频适合从文字构思场景;图生视频使用首帧确定开场构图,并可通过第二张图像指定结束画面。固定镜头设置可以帮助你要求稳定的观察视角,用于人物肖像、物体动作或细微变化的演示。
Seedance 1.5 Pro 由字节跳动 Seed 团队开发,Vidgo 提供模型调用服务。模型名称与商标归各自所有者所有。已有文字构思时,选择文生视频任务;已有照片或插画用于确定主体时,选择图生视频任务,并在需要指定结束状态时提供第二张图像。两种任务都支持设置视频时长、分辨率、画面比例与生成音频。

Seedance 1.5 Pro Text to Video turns written scenes into videos with synchronized audio and cinematic camera movement. It follows your scene, dialogue and action instructions to build cohesive short clips with expressive characters and coordinated sound.
Seedance 1.5 Pro Image to Video animates images with synchronized audio and first-and-last-frame guidance. It uses the opening image to anchor the subject and composition, while your prompt directs the action and camera movement.
文生视频任务根据提示词构建画面;图生视频任务将第一张图像作为首帧,并可将第二张图像作为尾帧,提示词用于说明两者之间的运动与需要生成的声音。查看下表中的原始任务介绍,再打开与已有素材对应的任务。
| 模型 / 任务 | 输入与工作流 |
|---|---|
| Seedance 1.5 Pro Text to Video | Seedance 1.5 Pro 文生视频根据文字场景生成包含同步音频与电影感镜头运动的视频。模型按照你对场景、对白与动作的要求,构建连贯的短视频片段,并呈现富有表现力的人物与协调的声音。 |
| Seedance 1.5 Pro Image to Video | Seedance 1.5 Pro 图生视频使用同步音频与首尾帧引导,让图像产生动画。模型通过首帧确定主体与构图,再根据提示词控制动作和镜头运动。 |
在提示词中写清可见动作与声音事件,通过输入图像确定起止状态,并选择成片所需的输出参数。下面的真实记录展示了如何将这些要求写入请求并检查生成结果。
同时描述场景、主体、动作与声音,并开启生成音频。雨夜巴士案例从文字构思出发,要求生成一段连续镜头;构思叙事片段时,可以结合结果中的动作、对白与环境氛围进行检查。
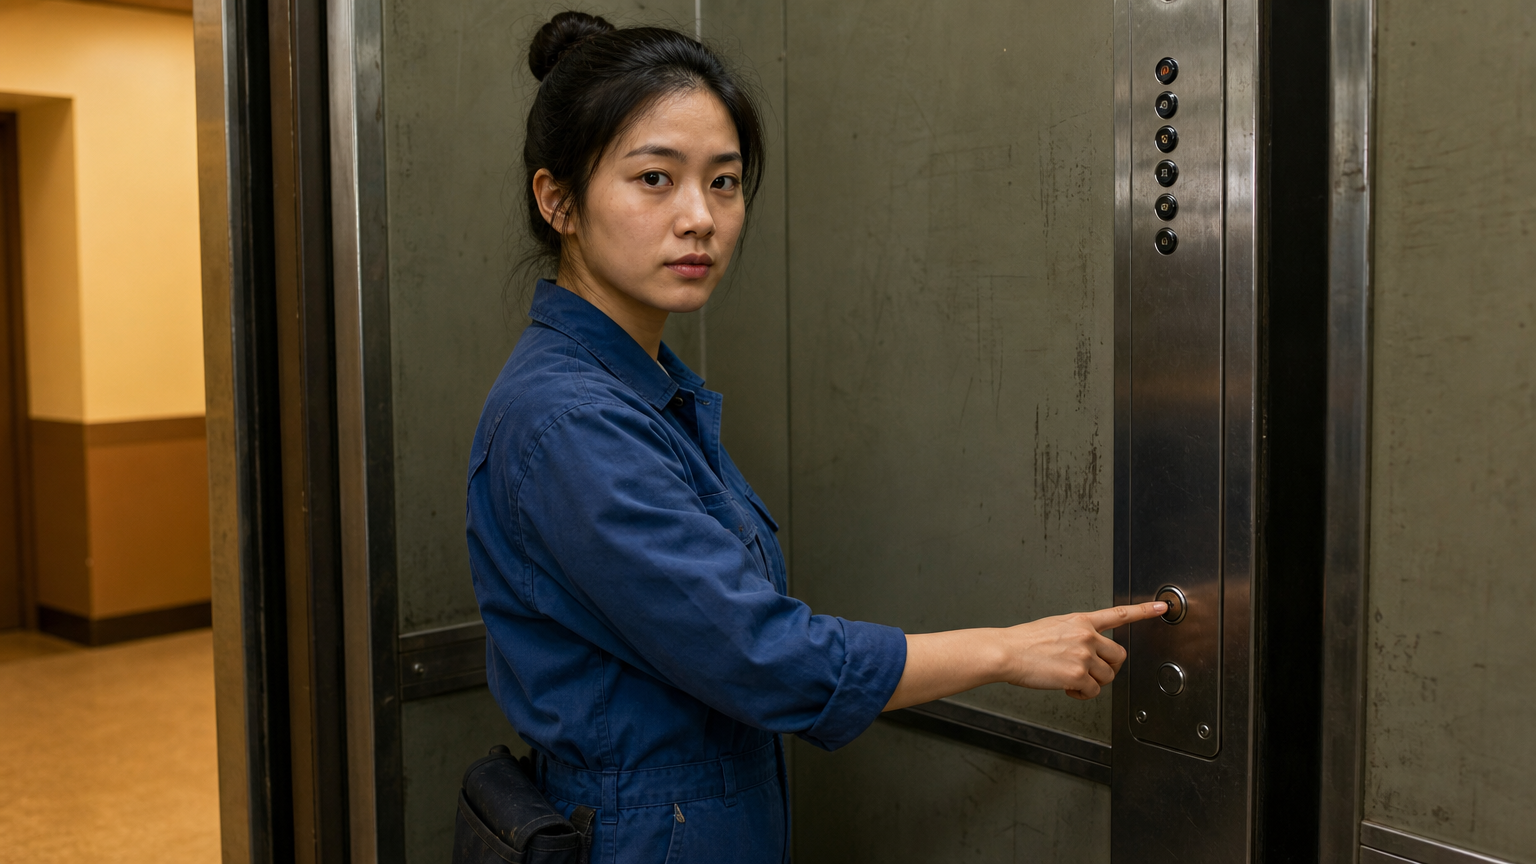
提供人物图像,写清细微动作和需要说出的具体内容。电梯案例要求人物持续按住按钮、微笑并说出一句中文,同时保持镜头固定;你可以检查面部连续性、口型变化与声音事件的时序。
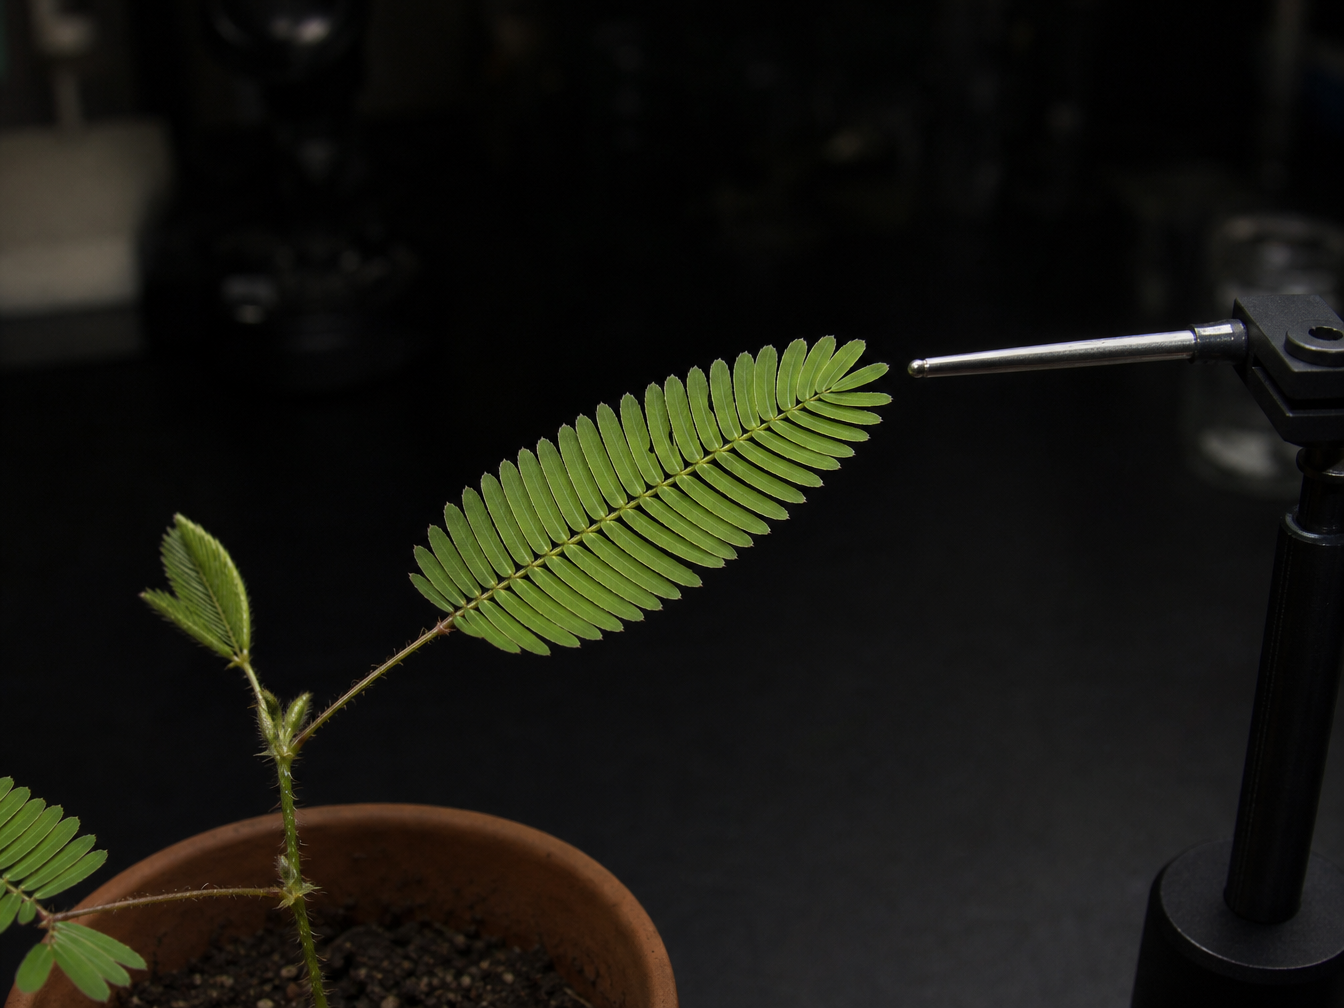
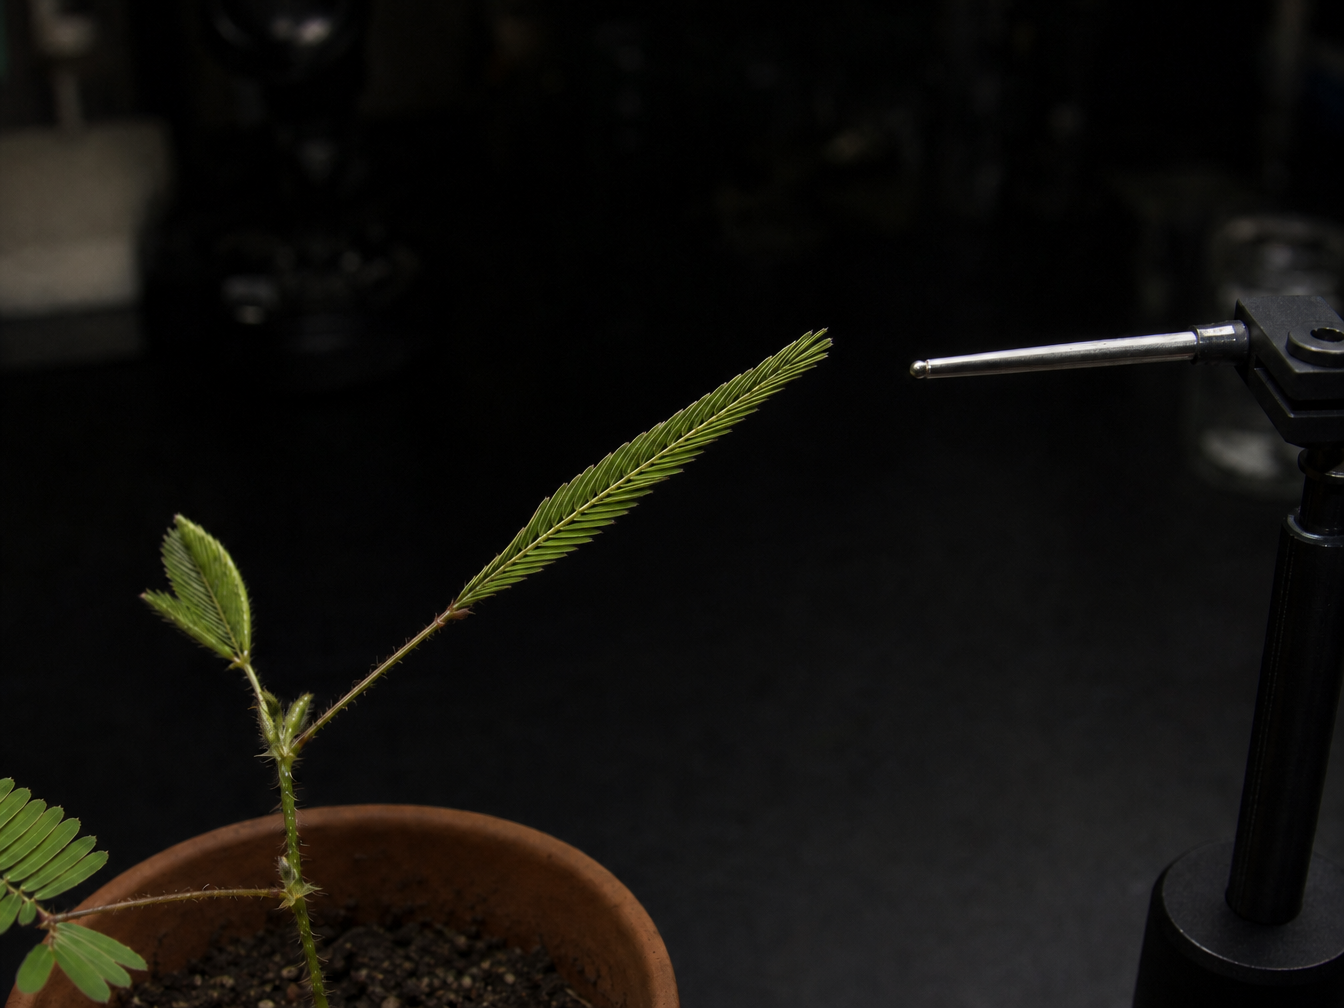
按照顺序提供首帧和尾帧图像。植物案例使用同一盆植株在叶片展开与闭合时的画面,为运动提供明确的起点与终点,再通过提示词说明中间的变化过程。
开启固定镜头设置,并说明场景中需要保持稳定的部分。植物案例要求探针轻微前进、叶片逐渐闭合,同时保持花盆、工作台与构图一致;稳定的观察视角有助于检查局部变化。
设置 4、8 或 12 秒时长,选择 480p、720p 或 1080p 分辨率,并从六种画面比例中选择方形、横向、超宽或竖向构图。根据时长安排动作节奏,再结合是否生成音频查看任务费用估算。
第一组记录以维修人员按住电梯按钮的照片为输入,要求生成细微动作、一句中文对白与电梯提示音。第二组记录提供两张植物图像,要求探针接触叶片后,细小叶片逐渐闭合。展开完整提示词,对照输入画面查看视频,并播放结果检查动作与声音。
将这张照片制作成一段八秒钟的克制、写实的电影人物肖像视频。照片中的年轻女维修人员是整个片段中唯一可见的人物。从首帧到尾帧,整个电梯与左侧空无一人的黄色走廊都要与照片完全一致并保持静止。固定镜头,保持裁切与光线不变。她的手指已经接触圆形按钮:让她轻轻按下按钮,并在整个片段中持续按住。只有表情与头部产生细微运动:她看向镜头左侧的一位画外邻居,友善地微笑,然后以自然、清晰的女性普通话只说一次:“别急,我等你。”保持无遮挡的面部、发髻、蓝色工装与手部结构同参考图完全一致。她说话前,完全在画外传来一小段远处脚步声;可见走廊始终空无一人。说完后,响起一声轻柔的电梯提示音。结尾保持温暖的小幅微笑与相同的按键位置。走廊中不要有人经过,不要出现重复人物、新的面孔或身体、人物倒影、门的移动、镜头运动、音乐、字幕或标志。
将提供的图像作为一段连续、固定镜头的四秒植物微距观察视频的首帧与尾帧。保持花盆、含羞草枝条、黑色工作台、作业照明、探针与构图完全一致。探针仅向前移动几毫米,短暂接触主要的展开复叶,然后稍稍后退。成对的小叶沿原有中央叶轴逐渐向内闭合,与尾帧中闭合的主叶相吻合。运动平滑、幅度小且局限于局部,不要出现新枝条、植株变形、镜头运动或剪切。探针发出细微、短暂的机械伺服声,并伴随安静的室内通风声;不要夸张的植物声音、讲话、音乐、标题或标志。
准备镜头文字描述或合适的首尾帧,写清动作与声音,并选择足以呈现这些事件的视频时长。生成结果可以用于叙事构思、动画研究或应用中的短视频场景。
准备清晰的人物图像,写出一句简短对白,并说明表情与手势。开启生成音频后检查人物面部和语音表现,将合适的片段用于角色构思或故事演示。
描述地点、可见活动与对应声音,使用文生视频探索雨天、交通工具或室内环境的氛围,并将生成片段作为音视频情绪研究素材。
将插画作为首帧上传,描述符合原构图的简短动作,并为使用位置选择画面比例与时长。检查生成片段后,将其用于动画构思或创意展示。
准备同一主体在起止状态下的两张图像,描述中间的运动,并要求固定观察视角,使植物反应、小型机构运动或物体状态变化更容易在演示中查看。
根据目标版面选择支持的画面比例,再写清主体位置与镜头方向。生成 4、8 或 12 秒片段,将构图研究用于社交视频或演示序列的规划。
保留在线测试中确认的提示词、按顺序排列的图像地址、音频选项与输出设置,通过 API 提交对应任务,并获取完成视频,用于应用中的创作流程。
Seedance 1.5 Pro 按生成视频计费,所选时长、分辨率与生成音频选项决定适用的价格档位,具体影响会体现在任务费用估算中。下方动态表格展示各任务当前可用的最低价格。打开任务后,设置实际的 4、8 或 12 秒时长与输出选项,查看本次请求对应的费用。
| 模型 | 厂商 | 任务类型 | 最多输入图像 | 最高输出分辨率 | 起价 |
|---|---|---|---|---|---|
| Seedance 1.5 Pro Text to Video | ByteDance | 文生视频 | 不适用 | 1080p | $0.045 / 个视频 |
| Seedance 1.5 Pro Image to Video | ByteDance | 图生视频 | 2 | 1080p | $0.045 / 个视频 |
先在线测试创作方案, 再将确认后的请求接入应用。
选择对应任务,查看参数与费用,并将在线测试中的素材和设置用于经过身份验证的 API 请求。
根据文字场景选择文生视频,或根据首帧与可选尾帧选择图生视频。准备提示词中的动作、镜头与声音要求,并按照画面在镜头中的作用排列输入图像。
打开对应任务,填写创作要求并提供所需图像。对照主体外观、构图与预期变化检查生成结果,确认后再将该工作流用于项目。
在任务页设置时长、分辨率与生成音频,查看对应的单个视频费用估算,并分别为短片段草稿与较长成片安排测试预算。
结合实际提示词、输入图像与生成结果查看案例,了解如何说明各张输入图像的作用,以及如何描述自己请求中需要保留或改变的细节。
保存 API 返回的任务 ID,用于查询生成状态并获取完成文件的地址。通过在线生成记录回看先前结果与测试过的创作方向。
通过各任务提供的文档查看准确的模型标识、支持的输入、身份验证方法与响应格式。接入已经在线测试过的任务,使请求中的素材与设置保持一致。
Seedance 1.5 Pro 是字节跳动 Seed 团队的视频模型,Vidgo 提供文生视频与图生视频任务。模型可生成 4、8 或 12 秒片段,支持 480p、720p 或 1080p 分辨率,并可设置生成音频、画面比例与固定镜头。
阅读模型介绍、API 接入指南与平台比较,了解项目所需的输入素材准备、请求接入方法与费用规划。