逐格规划漫画页面
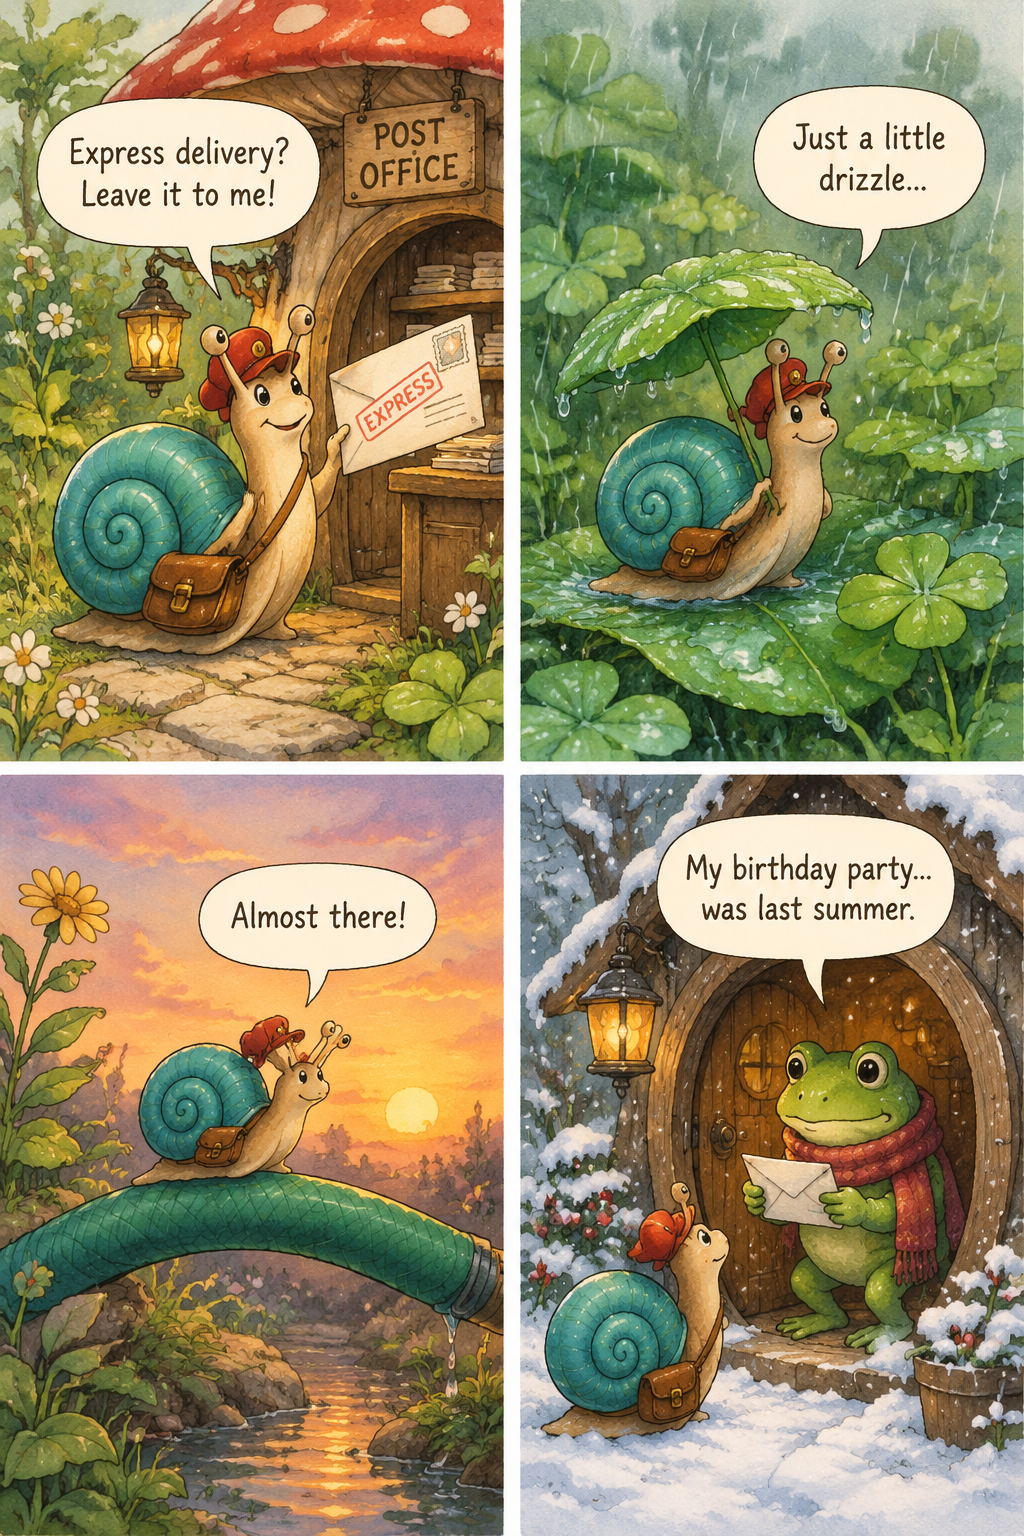
写清网格、重复出现的角色、各格动作与准确对话气泡。蜗牛记录要求 2×2 页面,从快递信件一直呈现到冬季送达,可以检查角色、分格顺序和气泡拼写,再将合适结果用于插画故事草稿。
GPT Image 1.5 可以根据文字指令创建图像,也可以结合参考图与可选蒙版编辑已有视觉内容。描述主体、场景、布局与准确文字,可以制作漫画页面、纪实场景或教育插画。编辑时,明确需要修改的物体或文字,也可以让不同参考图分别提供人物与目标环境。输出可以选择方形、竖向或横向像素尺寸;文字生成支持请求一至四张图像,文档列出的编辑工作流每次请求输出一张图像。
GPT Image 1.5 由 OpenAI 开发,Vidgo 提供模型调用服务。模型名称与商标归各自所有者所有。需要通过提示词确定完整场景、分格顺序或带标签插画时,选择文生图;已有参考图提供需要保留的身份、环境或物体时,选择图像编辑。描述目标变化和固定细节,需要按照选定区域编辑时增加蒙版,再选择输出尺寸。

Generate high-fidelity visuals from text prompts with GPT Image 1.5 Text to Image, featuring precise instruction adherence, in-image typography, and flexible aspect ratios at 2 credits ($0.010) per image.
Perform precision image editing and inpainting with GPT Image 1.5 Edit using reference images and text instructions, preserving subject identity and lighting at 2 credits ($0.010) per image.
文字生成使用 prompt、size 与 n;编辑还需要通过 image_urls 提供至少一个公开图像地址,可以增加 mask_url 指定区域。说明各张参考图的作用,以及需要保留的主体、位置、光线和文字。按照文档的单图编辑工作流,将 n 设置为 1。
| 模型 / 任务 | 输入与工作流 |
|---|---|
| GPT Image 1.5 Text to Image | GPT Image 1.5 Text to Image 根据文字提示词生成高保真视觉内容,支持精细的指令遵循、画面内文字与灵活画面比例,每张图像为 2 积分(0.010 美元)。 |
| GPT Image 1.5 Edit | GPT Image 1.5 Edit 结合参考图与文字指令完成精细图像编辑和局部重绘,并保留主体身份与光线,每张图像为 2 积分(0.010 美元)。 |
已有记录展示四格蜗牛故事、广播工作室照片、带标签的河狸巢穴、修改后的步道标牌,以及重新呈现为真实动物照片的绘画。结合实际输出,了解各项要求如何说明内容、顺序与需要保留的细节。
写清网格、重复出现的角色、各格动作与准确对话气泡。蜗牛记录要求 2×2 页面,从快递信件一直呈现到冬季送达,可以检查角色、分格顺序和气泡拼写,再将合适结果用于插画故事草稿。
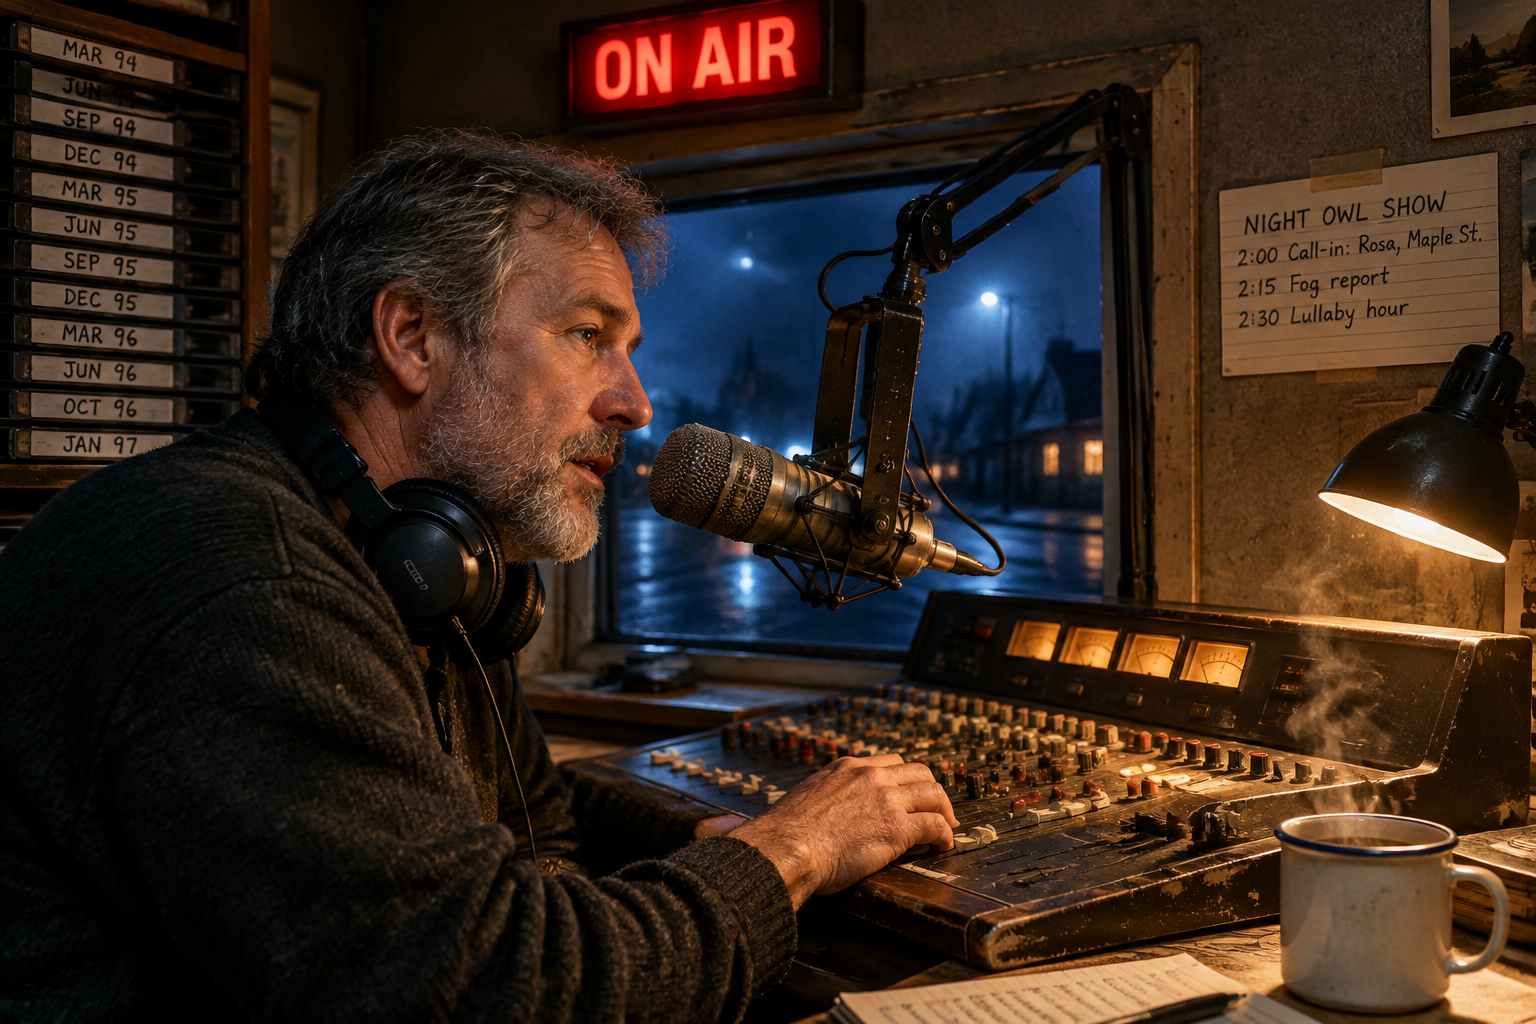
明确文字、所在表面与场景光线。广播记录包含 ON AIR 标牌、四行索引卡与带日期的磁带标签,可以结合主持人、麦克风及工作室冷暖光线检查每项文字,用于叙事静帧构思。
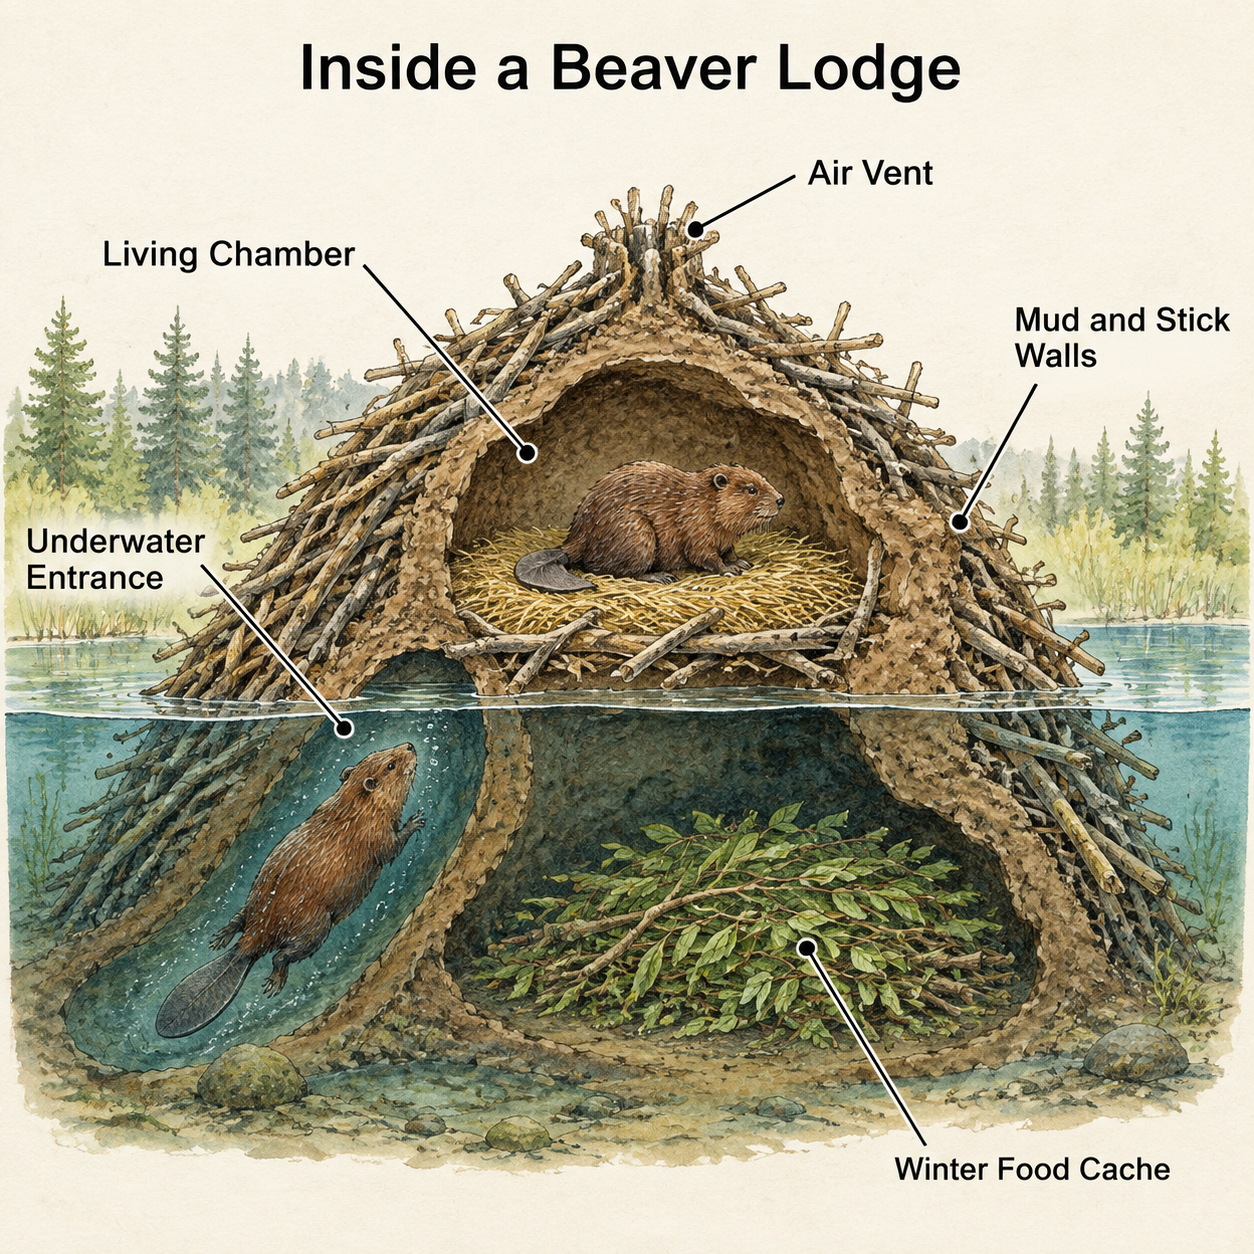
写清结构、准确标签及其对应位置。河狸巢穴记录要求五个标签、干燥巢室、水下入口与食物储藏区,可以检查形态、水线和标签连接,再将图像用于学习材料草稿。
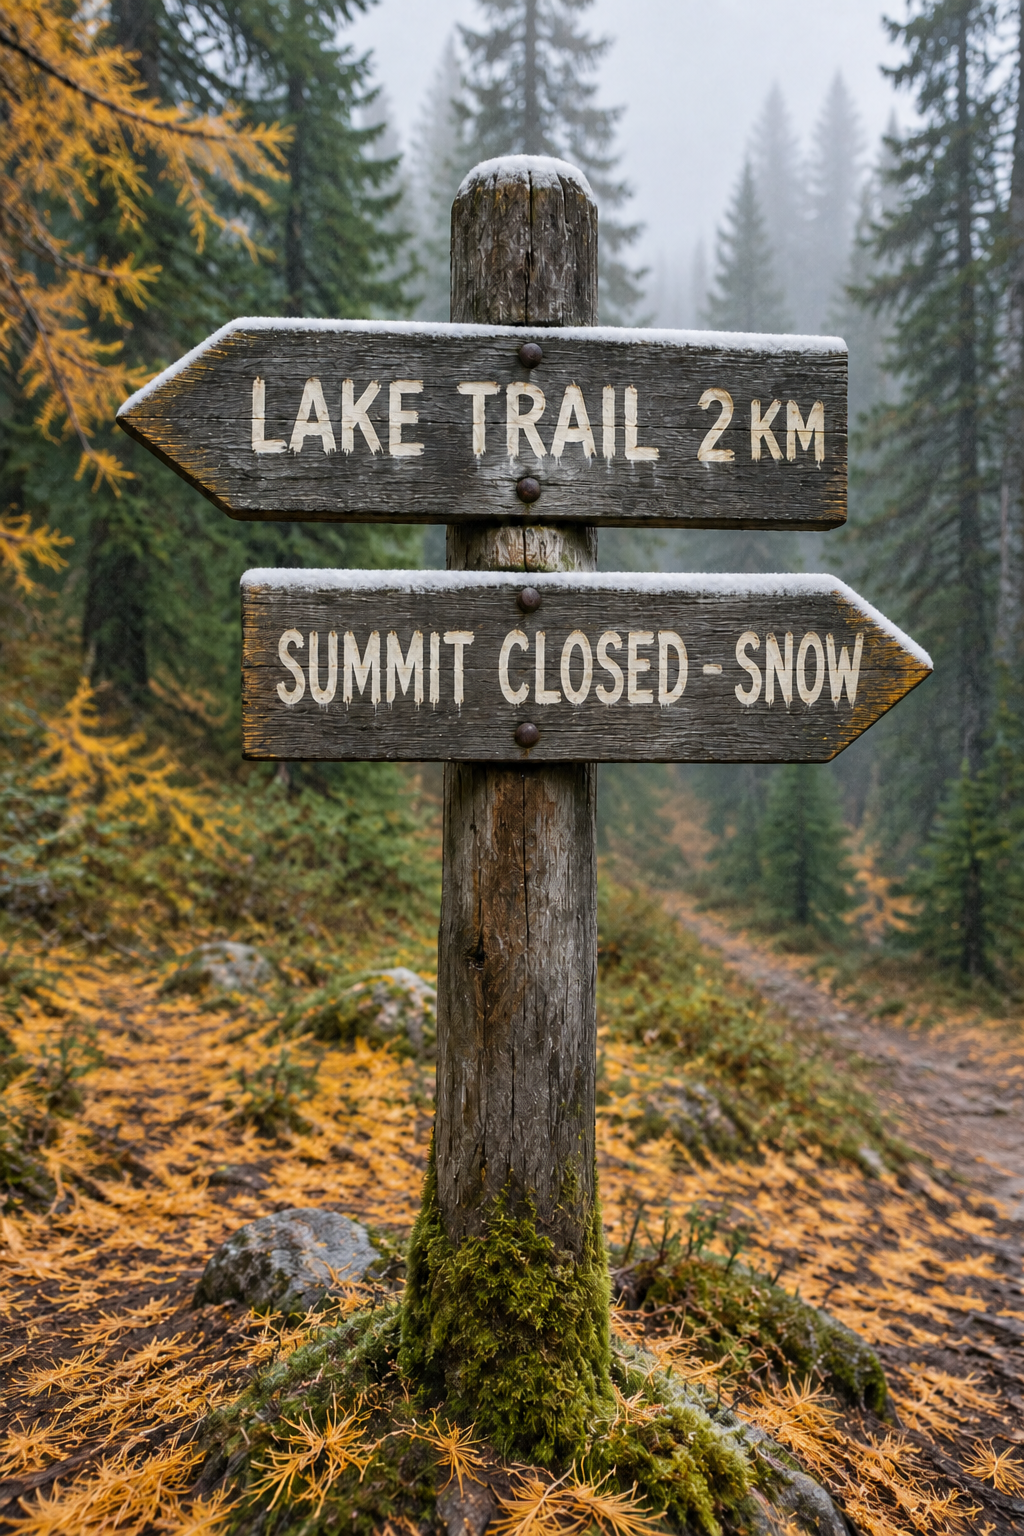
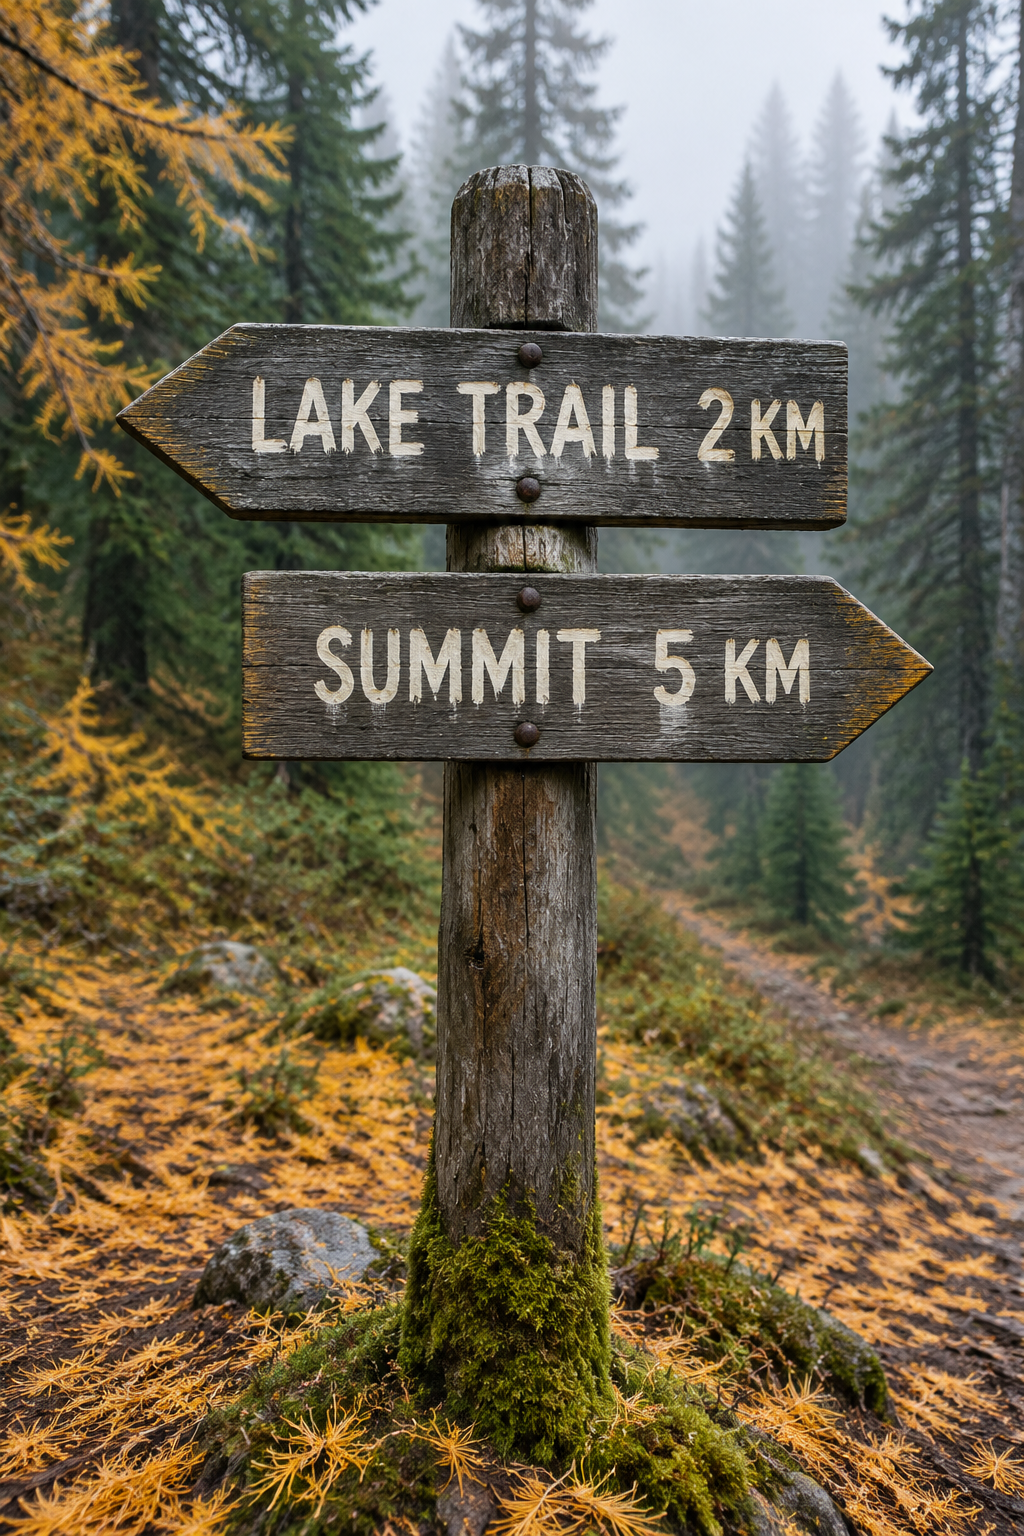
提供步道标牌照片,并明确下方木板。编辑将 SUMMIT 5 KM 替换为 SUMMIT CLOSED - SNOW,保留上方标牌和森林,并在边缘增加新雪,可以对照原图和结果检查拼写、笔触及局部天气变化。
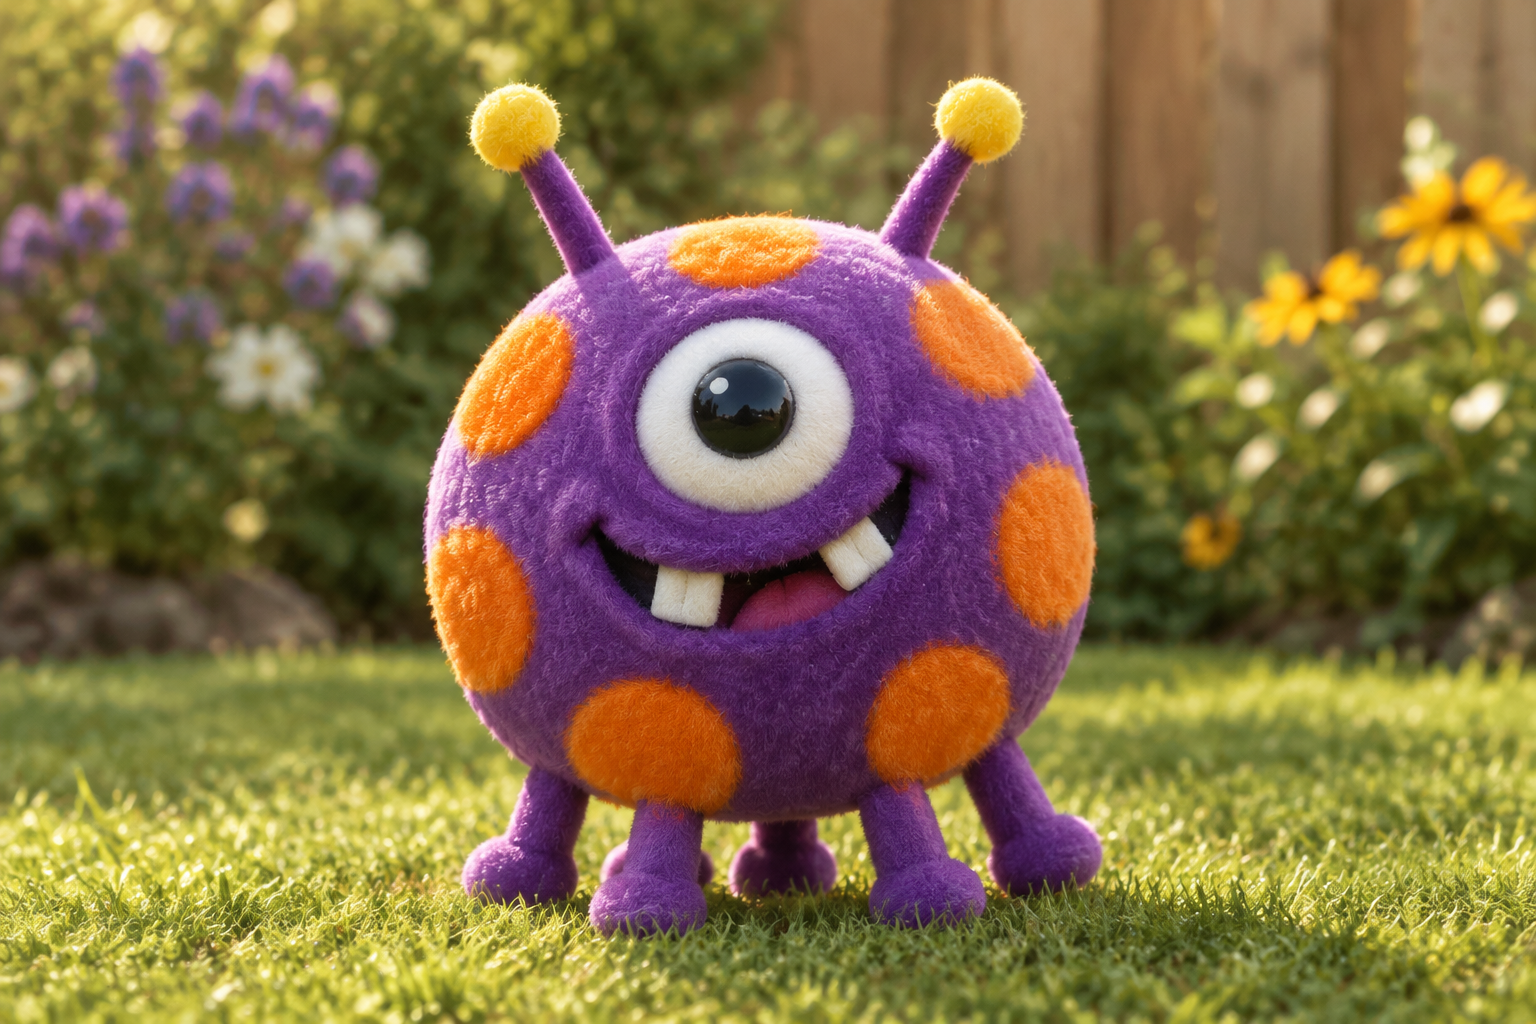
提供绘画,并列出决定角色设计的特征。编辑保留紫色身体、橙色斑点、六条腿、触角与一只眼睛,再要求柔软皮肤和花园接触阴影,可以对照来源检查设计及新的材料呈现。
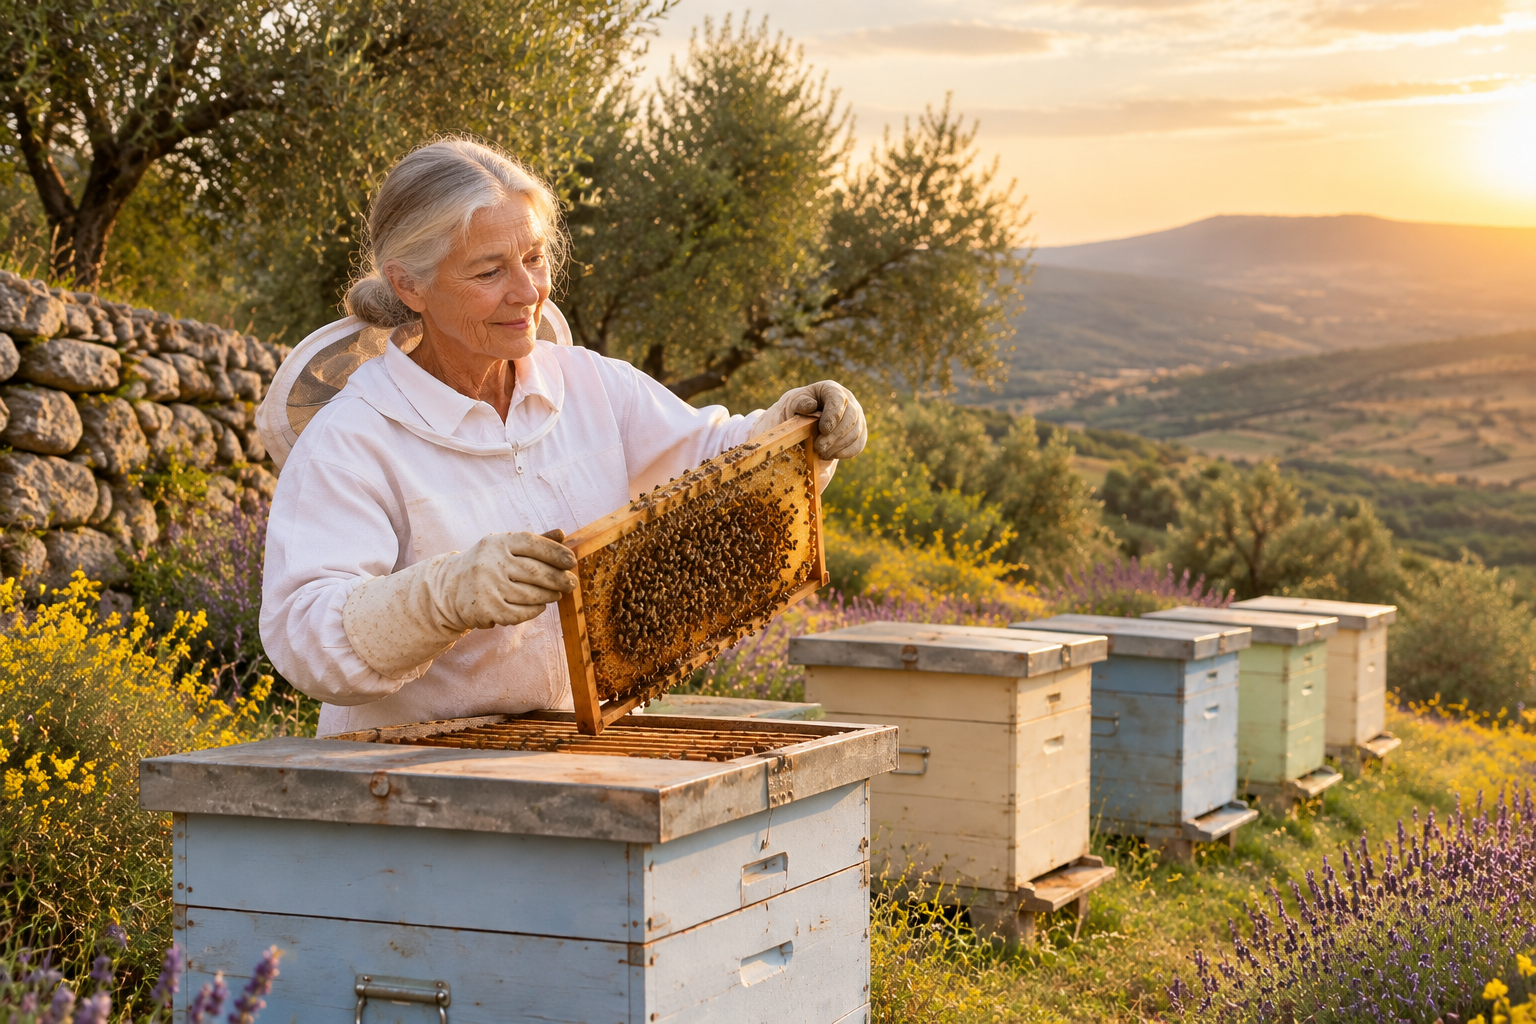
第一组案例使用步道标牌照片,修改一块木板上的文字并增加积雪,同时保留周围场景;第二组将女性身份参考与山坡蜂场组合,再要求观察蜂巢的姿态、保留蜂箱颜色,并匹配黄金时刻光线。阅读各组完整提示词,结合全部来源图像与对应结果检查变化。
仅编辑下方木板上的文字:将“SUMMIT 5 KM”替换为“SUMMIT CLOSED - SNOW”,使用相同的乳白色手刷大写字母,保持字高、笔触纹理与轻微不均匀感,并整齐放在同一块木板内。保留上方木板“LAKE TRAIL 2 KM”、两个箭头形状、立柱、木纹、镜头角度与森林的原样。然后仅在两块木板的上缘和立柱顶部增加一层薄薄新雪,并在空气中呈现少量轻盈雪花。不要其他变化、额外文字、标志或水印。
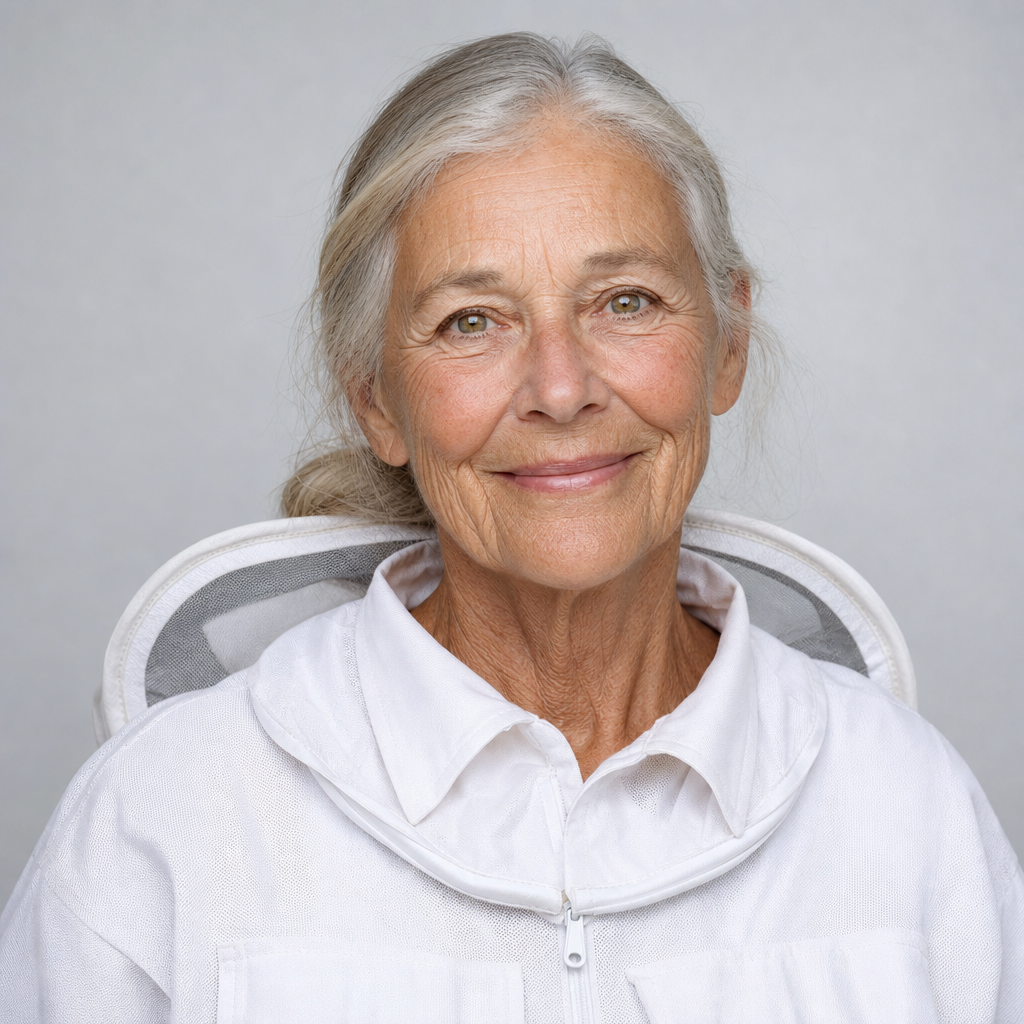
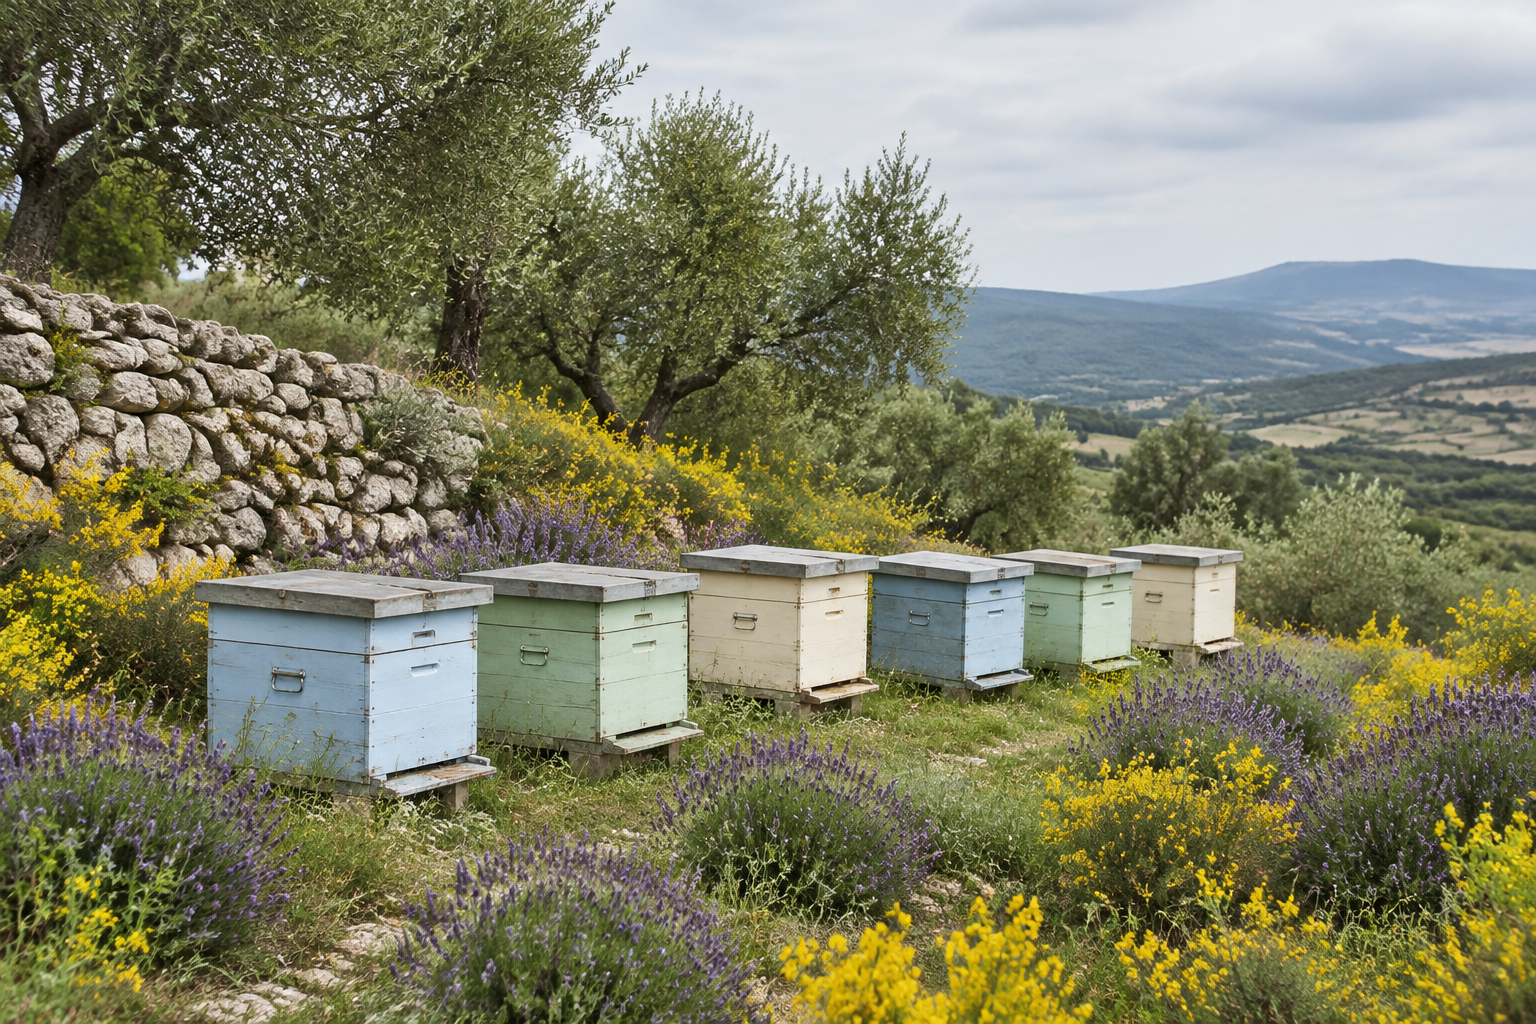
组合两张参考图。将图像 1 中的女性放入图像 2 的山坡蜂场。她站在第二个蜂箱旁,戴着手套的双手拿着刚取出的蜂巢框,仔细观察,周围飞着几只蜜蜂。让她的面部、年龄、银色发髻、榛色眼睛与白色养蜂夹克保持和图像 1 完全一致。保留图像 2 中彩绘蜂箱的颜色、薰衣草、石墙、橄榄树与山丘。将整幅场景重新照亮为从右侧照来的温暖黄金时刻阳光,地面阴影相互匹配,头发上有柔和轮廓光,使她看起来像自然地在当地拍摄。真实纪实照片,四分之三视角,不要文字、标志或水印。
准备完整文字要求或来源图像,说明顺序、准确文字、目标变化与保留细节,再选择适合的输出尺寸。检查后的图像可以用于漫画构思、纪实风格场景、教育草稿、标牌修改、角色开发与人物换景。分享完成作品前,需要检查事实内容、字形与身份特征。
写清分格顺序、重复角色与准确对话,生成页面并检查顺序和字形,再将确认后的图像用于短篇插画故事草稿。
描述人物、环境、光线与场景文字,生成摄影风格构图,再检查形态、物体位置与文字,用于电影构思或编辑插画。
明确对象结构、内部关系与准确标签,生成视觉说明并检查事实连接,再将确认后的草稿用于课程或学习页面。
提供已有图像,明确需要替换的文字与保留的表面,再检查编辑后的拼写、纹理与布局,用于场景更新或视觉修改提案。
提供草图,并明确决定设计的形状、颜色与特征,要求新的呈现媒介或真实环境,再对照原设计检查结果,用于角色开发。
提供身份与目标环境参考,并描述姿态、比例、光线与接触关系,再检查组合场景,用于插画叙事、场景提案或创作规划草稿。
下方动态表格展示文字生成与编辑当前的每张图像起价。文字生成的 n 接受 1 至 4,费用估算随请求图像数量增加;编辑文档明确每次请求输出一张图像,并按一张图像计费,该工作流使用 n=1。选择计划使用的像素尺寸,查看任务估算后再提交。
| 模型 | 厂商 | 任务类型 | 输入素材 | 输出尺寸 | 起价 |
|---|---|---|---|---|---|
| GPT Image 1.5 Text to Image | OpenAI | 文生图 | 文字提示词 | 1024x1024 / 1024x1536 / 1536x1024 | $0.01 / 张 |
| GPT Image 1.5 Edit | OpenAI | 图像编辑 | 至少 1 张参考图,可选蒙版 | 1024x1024 / 1024x1536 / 1536x1024 | $0.01 / 张 |
先在线测试创作方案, 再将确认后的请求接入应用。
选择对应任务,查看参数与费用,并将在线测试中的素材和设置用于经过身份验证的 API 请求。
通过完整文字构图创作时,选择文生图;来源图像确定需要保留或修改的内容时,选择图像编辑。编辑提供至少一张图像,需要指定区域时增加蒙版,再选择 1024x1024、1024x1536 或 1536x1024。按照所选任务文档设置输出数量。
打开对应任务,填写创作要求并提供所需图像。对照主体外观、构图与预期变化检查生成结果,确认后再将该工作流用于项目。
根据当前每张图像价格与文字任务的请求输出数量规划生成费用;按照文档使用单图编辑时,将 n 设置为 1,并查看展示估算。结合完整请求金额与计划测试次数安排项目预算。
结合实际提示词、输入图像与生成结果查看案例,了解如何说明各张输入图像的作用,以及如何描述自己请求中需要保留或改变的细节。
保存 API 返回的任务 ID,用于查询生成状态并获取完成文件的地址。通过在线生成记录回看先前结果与测试过的创作方向。
通过各任务提供的文档查看准确的模型标识、支持的输入、身份验证方法与响应格式。接入已经在线测试过的任务,使请求中的素材与设置保持一致。
GPT Image 1.5 是 OpenAI 的图像模型,Vidgo 提供文字生成与编辑任务,接受文字指令、参考图和可选编辑蒙版,并通过三种像素尺寸提供方形、竖向或横向结果。本页介绍对应输入、控制方式、案例与价格。
阅读模型介绍、API 接入指南与平台比较,了解项目所需的输入素材准备、请求接入方法与费用规划。